

 Новиков Игорь
Как сделать контент-завод на нейросетях и не потерять трафик всего сайта
7 сентября 2026 года представитель Google по поиску Джон Мюллер ответил в Bluesky владельцу сайта, собранного перебором комбинаций доменных имён, технологий и атрибутов. Сайт вдобавок расширялся сгенерированными фразами вида «what does php mean?». Так устроен программатик SEO: страницы собираются автоматически из шаблона и таблицы данных, по одной на каждую комбинацию. Мюллер написал, что такой подход часто приводит к сайту, который либо спам, либо пограничный спам, либо низкого качества.
Дальше в том же посте он сформулировал суть: «Легко собрать много страниц. Дать пользователям реальную ценность трудно». И вывод для конкретного сайта: «Наши системы, возможно, утратили доверие к тому, что ваш сайт даёт пользователям реальную ценность, на основе старых страниц».
Я строю контент-завод на ИИ для агентства «Звонко» и сразу сверил своё производство с этими словами. Из правил Google и справки Яндекса у меня получилось три вопроса, которые можно задать каждой странице до публикации.
Google не ввёл новое правило: та же позиция записана в политике с марта 2024 года
Пост Мюллера был неформальным ответом одному владельцу сайта. Google записал ту же позицию 5 марта 2024 года вместе с мартовским core update. Тогда в правилах появилось понятие scaled content abuse: «массовая генерация страниц с основной целью манипулировать позициями в поиске, а не помогать пользователям». Страница с этим определением последний раз обновлялась 28 августа 2026 года, за десять дней до поста Мюллера.
В официальном перечне пять примеров нарушения, и генеративный ИИ среди них один, рядом со скрейпингом, склейкой чужого контента, сетями сайтов и страницами с ключевыми словами без смысла. Позиция по инструменту старше самой политики: 8 февраля 2023 года в блоге Search Central Google написал, что вознаграждает качественный контент независимо от способа производства, а нарушением считает автоматизацию, включая ИИ, «с основной целью манипулирования ранжированием».
Августовское спам-обновление показало цену масштаба без пользы
Спам-обновление Google 18–21 августа 2026 года разобрал консультант Гленн Гейб. Один сайт из категории YMYL, где ошибка бьёт по деньгам или здоровью читателя, потерял позиции более чем по 200 000 запросов: программатик-страницы по странам сочетались на нём с блоками ИИ-текста внутри тех же страниц. У другого сайта было 1,5 млн проиндексированных URL, около 85% из них составлял программатик, и пострадал весь домен. Сайты в разборе анонимные, цифры даны по оценке консультанта. 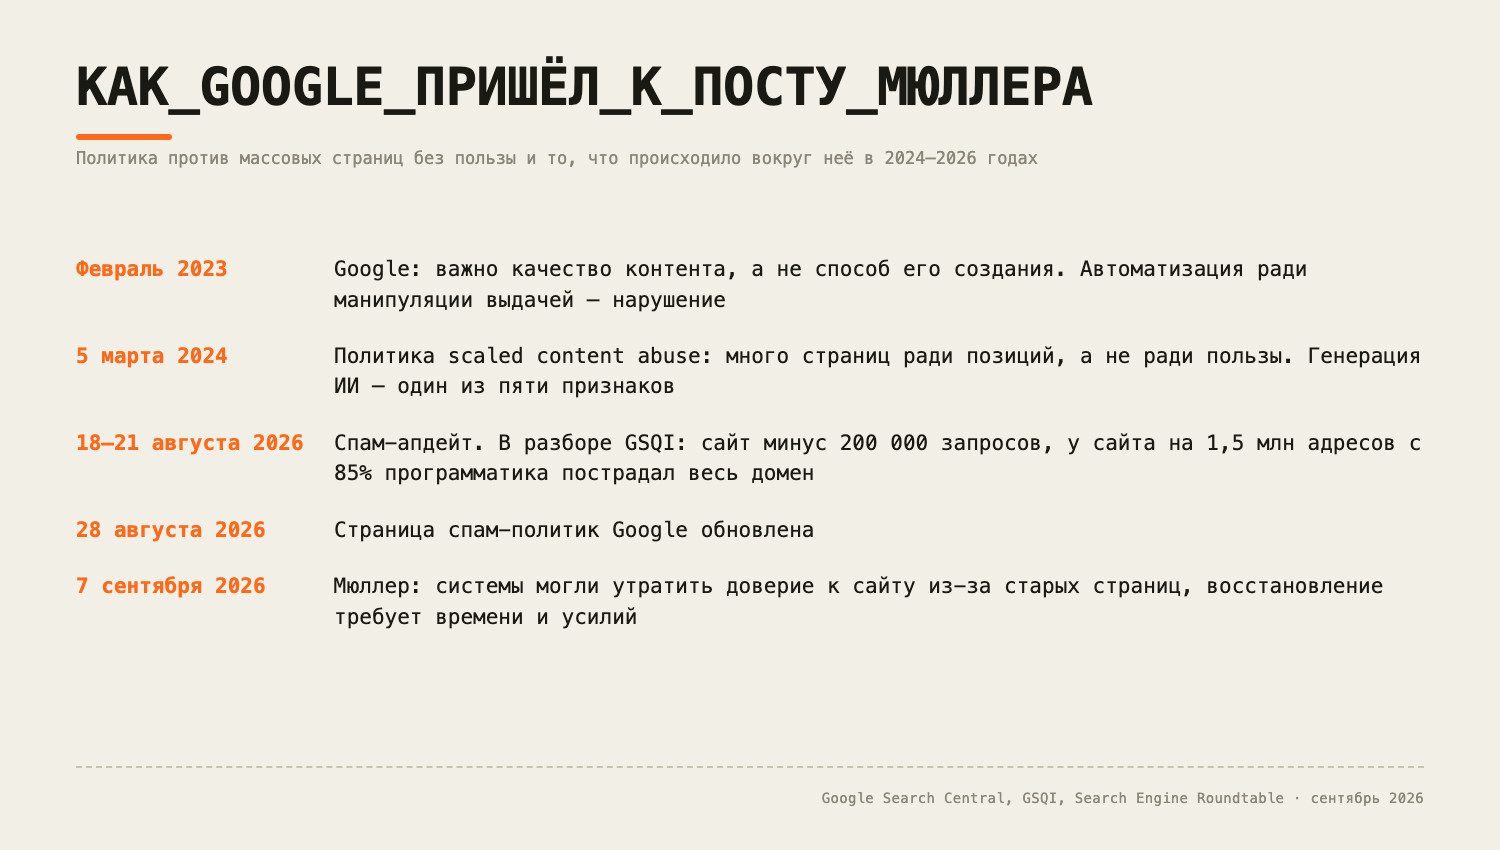
Хронология складывается в одну линию. Политика записана в марте 2024 года, в августе 2026-го спам-обновление прошлось по сайтам с массовыми страницами, а в сентябре Мюллер объяснил отдельному владельцу его проблему словами из той же документации. 31 августа инженер Google Раджан Пател подтвердил в соцсети, что команда по борьбе со спамом работает и после обновления.
Ещё одна деталь из разбора Гейба. В нём отмечено, что на пострадавшем партнёрском сайте текст в подвале страниц категорий детектор определял как сгенерированный ИИ с вероятностью выше 97%. Показания детектора причину просадки не доказывают, Гейб приводит их как наблюдение о шаблонном тексте на страницах категорий.
Яндекс индексирует любое число страниц, если они полезны
Справка Яндекс Вебмастера о малоценных и маловостребованных страницах говорит прямо: квот на число страниц в индексе нет, в поиск попадёт любое количество страниц, которые алгоритм признает полезными пользователям. Страница может не попасть в индекс, если дублирует известные роботу страницы, пуста или плохо отвечает на запросы. Оценивается каждая страница в отдельности, объём сайта сам по себе поводом для исключения не служит.
В англоязычных разборах поста Мюллера, которые я нашёл, Яндекс не упоминается, хотя его справка приходит к тому же выводу, что и кейс Гейба с 1,5 млн URL. Квот на число страниц у Яндекса нет, и при этом ограничение за малополезный контент может лечь на весь сайт. Для владельца сайта в рунете это значит, что оценивать стоит каждую страницу, а расплачиваться за слабые может весь домен.
Нарушения Яндекс называет иначе, чем Google. Справка «Безопасность сайта и нарушения» относит к ним использование SEO-текстов и малополезный контент, и ограничение ранжирования может распространиться на весь сайт, если нарушение относится к родительскому домену. В описании малополезного контента нейросети названы прямо: «Нередко такой контент создаётся с помощью нейросетей, машинного перевода или шаблонных методик... без дополнительного анализа и редактуры. При этом текст формально может быть оригинальным, но оставаться малополезным для читателя».
В марте 2024 года Яндекс обновил и алгоритм оценки качества контента «Проксима». В анонсе в блоге для вебмастеров к некачественному отнесён и автоматически созданный контент, который не несёт дополнительной ценности и не проверяется людьми. С Google совпал месяц, связи между двумя событиями никто не показал.
Как сделать контент-завод, который не превращается в генератор спама
Из правил обеих компаний я вывел три вопроса к каждой странице до публикации. Первый: есть ли на странице то, чего нет у других, то есть свои данные, опыт или разбор. В обзорах программатик-SEO этот признак называют рвом данных: у успешных проектов обычно есть свой структурированный набор данных, который конкурент не скопирует. Второй вопрос: есть ли на страницу спрос, или она появилась только потому, что комбинацию технически можно собрать. Из практики я бы проверял так: для каждой страницы из перебора посмотреть частотность запроса в Вордстате и показы страницы в Яндекс Вебмастере или Google Search Console. Страница без показов и без частотности становится кандидатом на уборку. Третий: прочитал ли страницу живой редактор, который заметит формально верную и пустую по содержанию фразу. 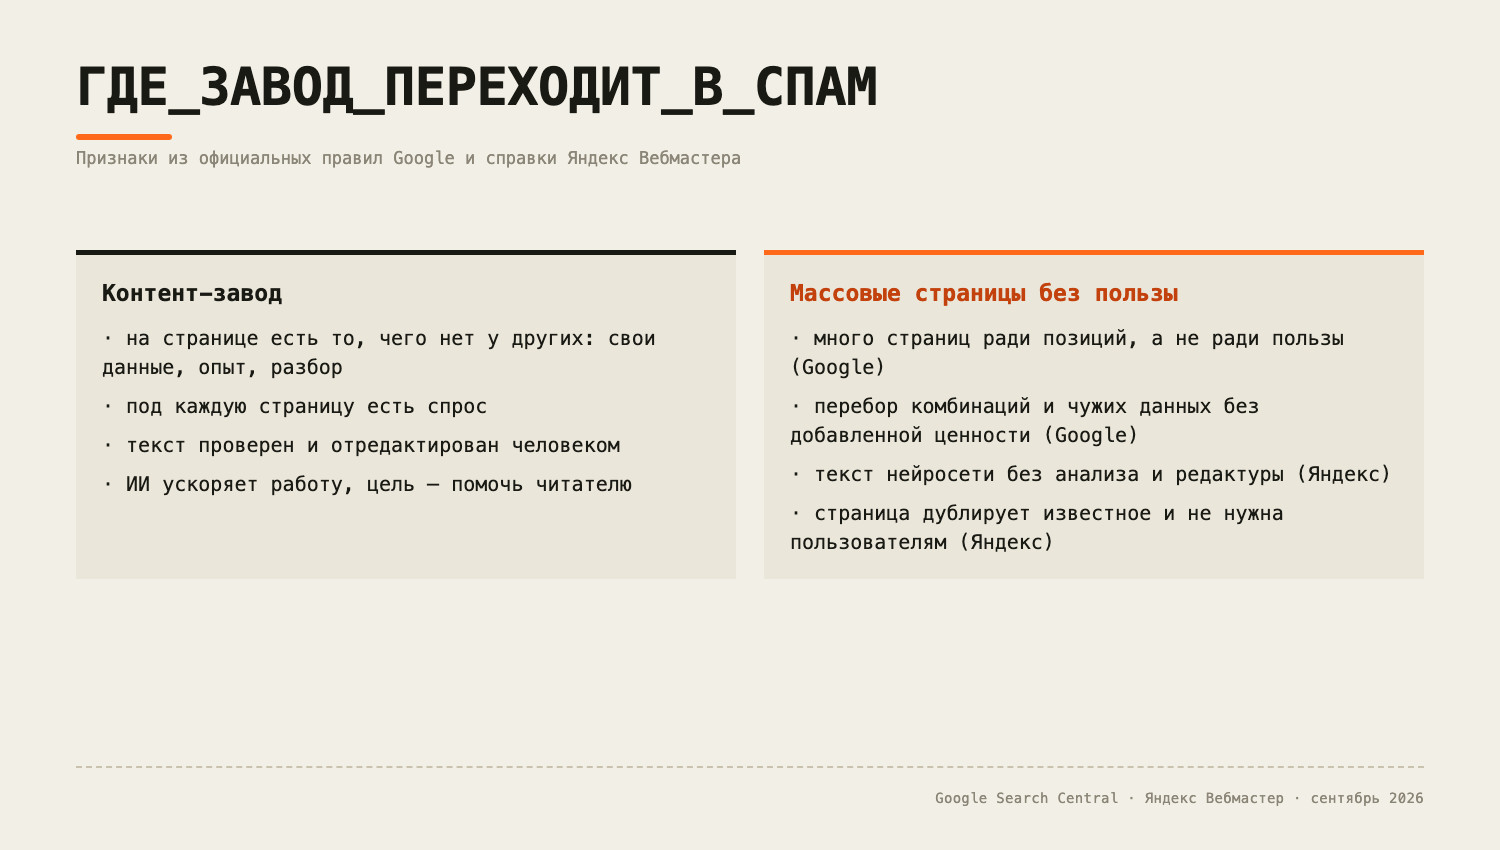
AI контент-завод у нас устроен так, чтобы эти вопросы разбирались до публикации. Нейросеть для генерации статей даёт черновик. Дальше каждая тема проходит бриф с проверенной фактурой, несколько версий текста под разными углами, отбор судьёй, редактуру, проверку на типовые приметы машинного текста и точность фактов. Число этапов само по себе ничего не гарантирует, смысл в том, чтобы после них на странице осталось что-то своё.
По трём вопросам проверка нашего завода показала следующее:
- Своё содержание. Статьи строятся на собственных замерах ответов нейросетей и разборе первоисточников. Если под тему нет своих данных в уже снятых замерах, статья не пишется: тема уходит в отчёт незакрытой с пометкой, какого замера не хватает. Так отсекаются как раз те темы, которые проще всего собрать из чужих пересказов.
- Спрос. Перед каждым текстом мы пробиваем Вордстат и ставим в заголовок запрос, который люди задают на самом деле. Эта статья в плане называлась «массовая генерация страниц». Вордстат 23 сентября 2026 года (широкое соответствие, все регионы, показы за месяц) дал по этой фразе 7 показов, по «программатик seo» 1, по «контент завод» 4 708, и среди них прямо про производство текстов «ai контент завод» 86 и «как сделать контент завод» 70. Поэтому в заголовке контент-завод: тема та же, а формулировку выбрал спрос.
- Редактура. Последним текст читает человек и решает, выходить ли ему.
Слабое место тоже видно: третий вопрос держится на внимании одного читателя, и этапы до него это внимание не заменяют.
С уже опубликованными массовыми страницами вывод практический. Если на все три вопроса ответ отрицательный, оставлять страницы в расчёте, что алгоритм их не заметит, рискованно. Мюллер написал, что на исправление «обычно уходит время и значительные усилия, чтобы показать ценность», а в кейсе с 1,5 млн URL пострадал весь домен. Рабочий порядок такой: дописать уникальные данные там, где они есть, остальное отдать на редактуру человеку, а страницы без спроса убрать одним из трёх способов:
- закрыть от индексации метатегом noindex;
- склеить близкие страницы переадресацией 301 на одну сильную;
- удалить то, что никому не нужно, с кодом ответа 404 или 410.
Выбирать я бы стал так. Есть близкая сильная страница, а на слабую ведут ссылки или приходит хоть немного трафика, значит, 301. Страница нужна посетителям сайта, например как фильтр каталога, но не поиску, значит, noindex. Не нужна никому, значит, 410. Показы и частотность смотреть минимум за последние три месяца, чтобы не снять сезонную страницу.
Google и Яндекс много лет повторяют одну мысль: оценивают цель и пользу каждой страницы, способ её изготовления вторичен. Мы в «Звонко» строим производство вокруг этой мысли. Как устроен процесс и как мы проверяем статьи на факты и цитируемость, можно посмотреть на zvonkooo.ru.
