



Почему развитие искусственного интеллекта увеличивает спрос на качественную разметку данных для компьютерного зрения I объясняет US-DATA
От городских камер до заводских линий: как компьютерное зрение меняет Петербург
Искусственный интеллект все активнее выходит за пределы лабораторий и IT-компаний. Системы компьютерного зрения анализируют городские улицы, помогают контролировать производство, следят за движением транспорта и находят дефекты продукции. Но за способностью нейросети «видеть» стоит большой объем работы с данными, который обычно остается за кадром.
Еще несколько лет назад искусственный интеллект для многих компаний оставался экспериментальной технологией. Сегодня ситуация меняется: AI становится частью реальной инфраструктуры городов и предприятий.
Особенно заметен этот тренд в Санкт-Петербурге. В 2026 году город продолжил расширять применение искусственного интеллекта в городском хозяйстве. В сентябре власти Петербурга сообщили о новых сценариях использования нейросетевых комплексов для контроля городской среды.
Одновременно AI становится одним из направлений цифровой трансформации промышленности. На ПМЭФ-2026 было подписано соглашение о развитии проектов, связанных с внедрением искусственного интеллекта и машинного обучения на предприятиях Санкт-Петербурга. Среди отдельных направлений прямо обозначены компьютерное зрение, анализ больших данных и интеллектуальные системы поддержки принятия решений.
Петербург развивает и технологическую инфраструктуру вокруг AI: в городе создаются новые центры обработки данных, развивается ИТМО Хайпарк, а искусственный интеллект уже занимает заметное место среди продуктов местных малых технологических компаний.
Машины учатся видеть
Компьютерное зрение — одно из наиболее прикладных направлений современного AI. Такие системы получают изображения или видеопоток с камер и пытаются определить, что именно находится в кадре и что там происходит.
На производстве алгоритм может обнаруживать дефекты деталей, контролировать наличие средств индивидуальной защиты или следить за технологическим процессом. В логистике — считать объекты и анализировать перемещение грузов. В городской инфраструктуре — распознавать автомобили, дорожные ситуации и различные события.
Развитие роботизации только увеличивает потребность в таких технологиях. В июне 2026 года в Петербурге был открыт завод по серийному производству промышленных роботов и автоматизированных систем хранения для производственной и складской логистики.
Но камера сама по себе ничего не понимает. Более того, даже современная нейросеть изначально не знает, где на фотографии автомобиль, где человек, где дефект детали, а где номерной знак.
Чтобы алгоритм научился различать объекты, ему необходимы примеры.
И здесь начинается менее заметная часть AI-индустрии — подготовка и разметка данных для машинного обучения.
Что находится за кадром компьютерного зрения
Представим несколько тысяч фотографий автомобилей. Для человека автомобиль и его номер очевидны. Для необученной модели это лишь набор пикселей.
В процессе разметки изображений специалисты превращают эти фотографии в структурированные данные: выделяют нужные объекты, присваивают им категории и дополнительные атрибуты.
В зависимости от задачи используются разные технологии. Например, объект можно выделить прямоугольной рамкой — bounding box. В других проектах требуется практически пиксельная точность, поэтому применяются полигоны или маски. Если системе необходимо анализировать видеопоток, задача усложняется еще сильнее: важно не только обнаружить объект, но и сохранить его идентификатор при перемещении между кадрами.
Так появляется обучающий датасет — набор примеров, на которых алгоритм может изучать закономерности.
Именно поэтому качество исходных данных напрямую влияет на то, насколько хорошо модель впоследствии будет работать за пределами тестовой среды.
Реальность сложнее идеального датасета
Одна из основных проблем возникает тогда, когда модель встречается с реальным миром.
На демонстрационном изображении объект может быть хорошо освещен, полностью находиться в кадре и сниматься практически фронтально. В реальной эксплуатации камера оказывается под другим углом, объект частично перекрывается, появляется снег, грязь, тень, отражение или засветка.
Поэтому при подготовке данных важно не только разметить большое количество изображений, но и правильно обработать сложные и пограничные случаи.
Такую задачу команда US-DATA решала в одном из проектов, связанном с распознаванием автомобильных регистрационных знаков.
Кейс US-DATA: когда автомобильный номер оказывается не таким простым объектом 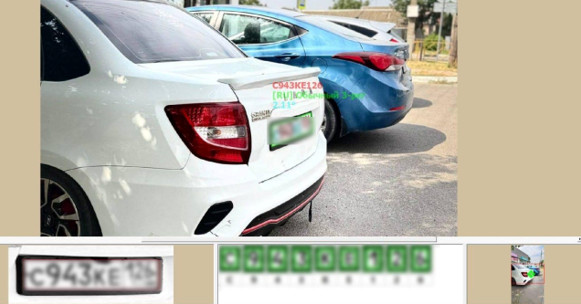
На первый взгляд задача выглядит стандартно: необходимо научить систему находить автомобильный номер и распознавать его содержание.
На практике датасет требовал сразу нескольких типов аннотаций. На изображениях выделялась рамка номерной пластины, фиксировалось текстовое значение номера, определялась страна и дополнительно указывался тип транспортного средства.
Определение страны тоже не всегда сводилось к чтению готового обозначения. Если код отсутствовал или был плохо различим, необходимо было ориентироваться на формат самого регистрационного знака.
Основная сложность заключалась не в типовых фотографиях, а именно в пограничных случаях.
Часть номеров была покрыта грязью, снегом или дорожными реагентами. Некоторые символы оказывались затерты, другие перекрывались бликами. Встречались фотографии, снятые под сильным углом или с необычной позиции.
Отдельной проблемой стали визуально похожие символы разных алфавитов. Кириллические «С», «Р» или «У» на изображении могут быть очень похожи на латинские C, P и Y. При плохом качестве изображения возникают и другие неоднозначные пары символов.
Еще один сложный сценарий — ночная съемка. Яркий источник света или вспышка способны превратить небольшую номерную пластину практически в белое пятно.
Для модели именно такие примеры особенно важны: AI-система должна работать не только с идеальными изображениями, но и с данными, максимально близкими к условиям будущей эксплуатации.
Поэтому в проекте применялись единые правила аннотирования, предварительно разбирались неоднозначные примеры, а готовая разметка проходила дополнительный контроль качества. Такой подход позволяет поддерживать единый стандарт на всем датасете даже тогда, когда часть изображений допускает разные визуальные интерпретации.
Для задач, где необходимо определить местоположение объекта на изображении, применяется, например, детекция объектов. Если системе требуется анализировать последовательность кадров, используются разметка видео и трекинг движения объектов.
Почему разметка — это не просто обвести объект
Чем сложнее ML-проект, тем меньше работа с данными похожа на механическое проставление меток.
До массовой разметки необходимо определить классы и правила, разобрать спорные ситуации и понять, какую информацию действительно должна получать модель.
Затем выполняется пилотная разметка. На небольшом наборе данных проверяется, одинаково ли команда понимает техническое задание и подходят ли выбранные аннотации для задачи заказчика.
После запуска основной работы появляется еще один важный процесс — контроль качества. Если одинаковые объекты в разных частях датасета размечены по-разному, модель получает противоречащие друг другу обучающие примеры.
Поэтому при крупных проектах значение имеют не только количество размеченных единиц, но и единые гайдлайны, проверка спорных случаев и согласованность всего набора данных.
По сути, компания получает не просто массив картинок с отметками, а готовый датасет, который должен соответствовать будущему ML-пайплайну.
От разметки к реальным AI-системам
По мере распространения компьютерного зрения спрос на подобные данные будет возникать в самых разных отраслях.
Для промышленности это распознавание брака и контроль производственных операций. Для складской логистики — идентификация и перемещение объектов. Для транспорта — обнаружение автомобилей, пешеходов и дорожной инфраструктуры. Для робототехники — понимание окружающего пространства.
В других задачах прямоугольной рамки уже недостаточно. Когда требуется максимально точно определить форму объекта, применяются полигональная разметка изображений или разметка масками.
В результате развитие AI постепенно формирует целую инфраструктуру вокруг данных: от их сбора и очистки до аннотирования, проверки качества, обучения моделей и последующего дообучения на новых ситуациях.
Качественные данные становятся частью AI-инфраструктуры
Санкт-Петербург уже показывает, как искусственный интеллект постепенно переходит из категории перспективных разработок в практический инструмент городской инфраструктуры и промышленности.
Следующий этап — масштабирование таких решений.
Но чем больше AI взаимодействует с физическим миром, тем выше требования к данным. Нейросеть должна правильно работать не только в хорошую погоду и при идеальном освещении, но и ночью, под неожиданным углом, при частичном перекрытии объекта или низком качестве изображения.
Именно поэтому за каждой системой компьютерного зрения стоит не только архитектура нейронной сети и вычислительные мощности. За ней стоят тысячи и миллионы примеров, которые помогают алгоритму понять окружающий мир.
US-DATA занимается подготовкой таких данных для проектов машинного обучения и компьютерного зрения: от разметки изображений и видео до детекции, сегментации, классификации и трекинга объектов. Компания работает как с пилотными проектами, так и с большими массивами данных, формируя датасеты под требования конкретных ML-моделей.