


Как проверить бэкап за один рабочий день и понять, спасет ли резервная копия бизнес
Для тех, кто вечно занят: резюме статьи за 1 минуту
- Копия еще не готовность к аварии. Она должна быть свежей и целой, лежать отдельно от рабочих данных, а после восстановления сотрудники должны снова проводить в системе рабочие операции.
- Бизнесу тест дает две цифры: RPO (точка восстановления) показывает, сколько данных пропадет, а RTO (время восстановления) — через какое время сервис снова станет доступен.
- Тест в шесть шагов: одна критичная система, копия из отдельного хранилища, развертывание в изоляции, проверка рабочих операций, замер времени, сравнение с тем, что нужно бизнесу.
- Первый тест чаще всего выявляет что-то из этого: копии лежат рядом с данными, пустые или устаревшие, восстановление идет слишком долго, зависимости не описаны, а процедуру знает один человек.
- Для критичных систем разумный минимум — тест раз в полугодие, конкретный ответственный и журнал проверок.
На связи Авдей Мартынович, руководитель подразделения по работе с малым и средним бизнесом в ALP ITSM. Расскажу, как проверить, выручит ли бэкап бизнес, и что делать, если проверка провалилась.
На первой встрече с собственником разговор о резервных копиях обычно короткий. Спрашиваю, есть ли они, и слышу:
— Есть, конечно. Админ все настроил, копия делается каждую ночь.
Тогда уточняю:
— А когда вы последний раз восстанавливали из нее все целиком? Не один файл, который кто-то удалил по ошибке, а сервер, базу 1С или почту, чтобы сотрудники вернулись к работе?
Чаще всего ответ один: «никогда».
Винить администратора здесь не спешите. Возможно, перед ним ни разу не ставили задачу проверить, получится ли из копий вернуть рабочий сервис в срок, приемлемый для бизнеса.
Дальше опишу несложный сценарий: за один рабочий день он дает честный ответ и не затрагивает действующую инфраструктуру.
Резервная копия есть. Значит ли это, что компания восстановится?
Файл с копией сам по себе бизнес не спасет. Чтобы восстановление сработало, заранее проверьте условия:
- копия свежая и не повреждена;
- копия лежит отдельно от сервера или диска с рабочими данными;
- есть доступ к учетным записям, паролям, ключам и лицензиям;
- известно, в каком порядке запускать системы, которые зависят друг от друга;
- после восстановления система не только включается, но и дает сотрудникам проводить рабочие операции;
- на восстановление уходит не больше времени, чем бизнес готов ждать;
- пространство для целевого восстановления готово, либо есть понятный сценарий по его созданию, с конкретными сроками.
Чаще всего уверенность «у нас все копируется» расходится с настоящей готовностью к аварии именно на этих пунктах.
Например, систему расчета зарплаты можно поднять за несколько часов и обнаружить, что работать в ней нельзя. За годы доработок она обросла зависимостями: берет данные из пропускной системы, личных кабинетов сотрудников и нескольких интеграций. Сервер формально работает, а посчитать зарплату не получается.
Или копирование месяцами идет с ошибками репликации, а бизнес и ИТ видят в отчете привычное «задание выполнено». Когда доходит до восстановления, копия оказывается неполной, битой или слишком старой, чтобы с ней работать. Часто об этом узнают только во время настоящей аварии. Если повезет — на тесте.
Типичная ошибка — держать рабочие данные и резервные копии на одной площадке. Тогда при отказе сервера, пожаре, краже техники или атаке шифровальщика под угрозой сразу и данные, и копии.
С кибератаками риск особый. После шифровальщика компания может восстановиться, так и не выяснив, как произошел инцидент. Если у злоумышленника остался доступ или вредоносный код успел попасть в копии, повторное восстановление вернет вместе с данными и проблему. Бэкап откатывает систему в прошлое, но причину атаки не убирает.
Что можно узнать за день теста
Тест восстановления проверяет больше, чем создание копии: он показывает, получится ли снова работать после сбоя.
За день тест отвечает на четыре вопроса:
- есть ли копия, из которой можно восстановиться;
- какой она давности;
- сколько длится развертывание, хотя бы грубо оценив по объемам данных и скорости их передачи;
- можно ли на самом деле работать в восстановленной системе.
Бизнесу из этого нужны две отдельные цифры. 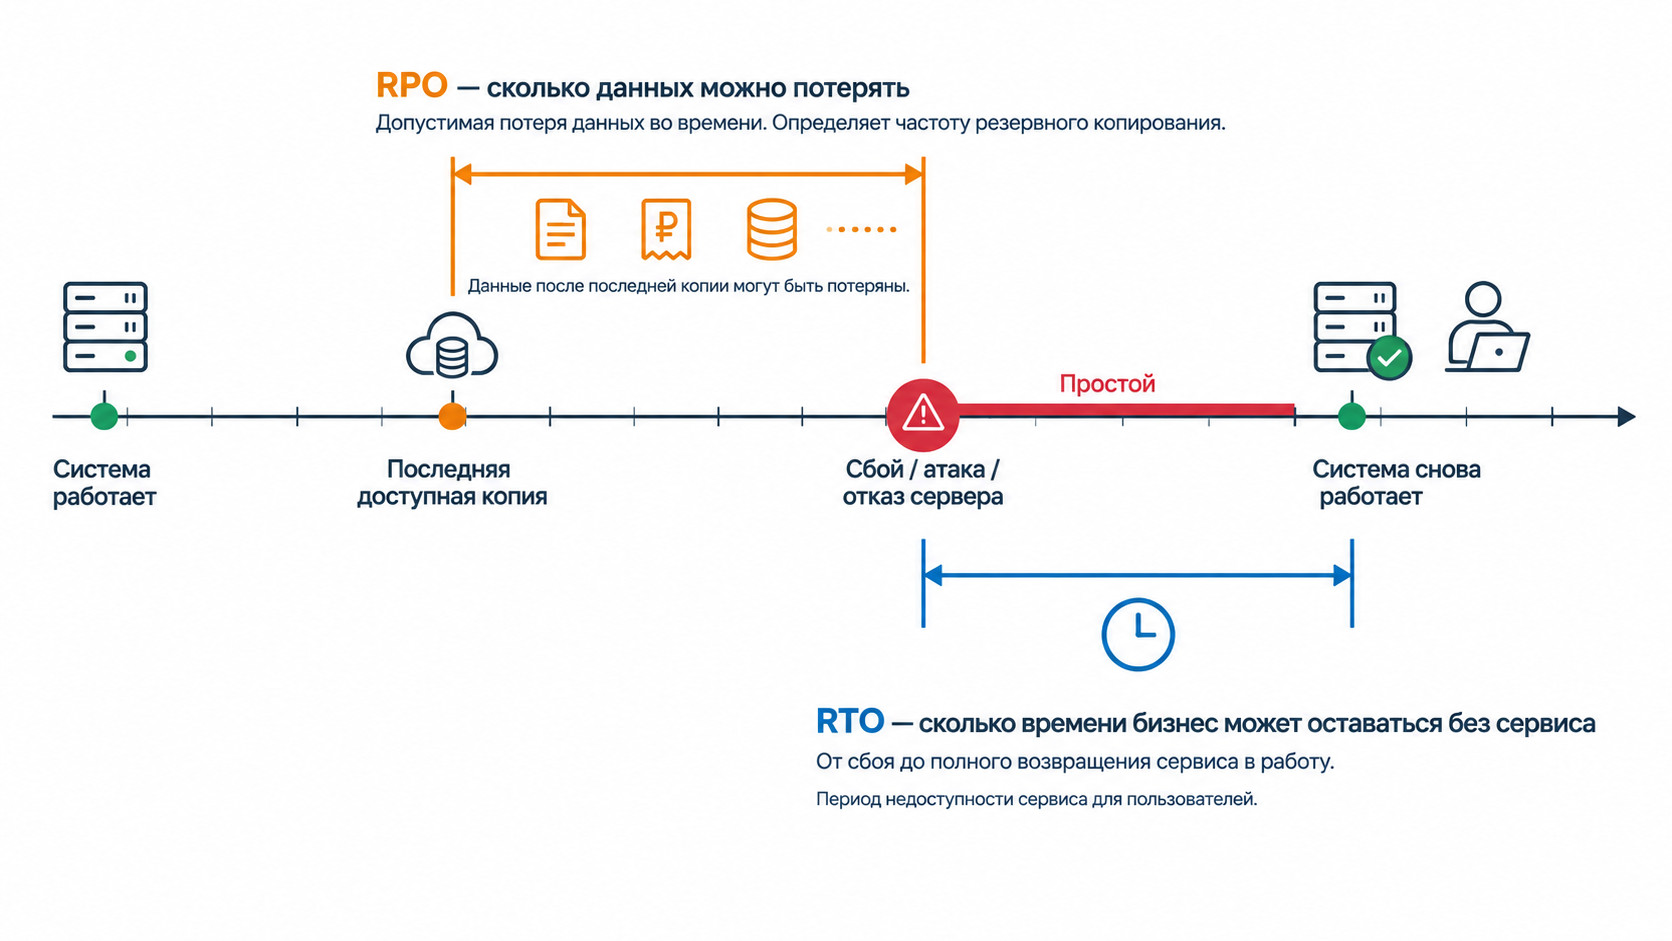
RPO (Recovery Point Objective, точка восстановления) отвечает, сколько данных компания потеряет при аварии. Допустим, последнюю рабочую копию 1С сделали в 02:00, а сбой случился в 14:00. Тогда под угрозой до 12 часов работы: документы, оплаты, заказы, правки в справочниках.
RTO (Recovery Time Objective, время восстановления) отвечает, сколько времени пройдет, прежде чем сервис снова заработает. Считается не распаковка архива, а весь путь от решения «восстанавливаемся» до момента, когда сотрудник заходит в систему, видит актуальные данные и проводит операции.
Как из RPO и RTO собрать план аварийного восстановления, я разбирал в статье.
На экспресс-аудите в розничной сети примерно на сорок точек бизнес рассчитывал, что 1С вернется в работу за час. В ходе диалога между собственником и ИТ-руководителем выяснили, что восстановление заняло не менее четырех часов. Расхождение никого не беспокоило, пока не зашла речь о проверке. А тест заменил бы компании догадки измеримым фактом.
Единой «правильной» частоты копирования или нормативного срока восстановления для критичных систем нет. Их определяет конкретный бизнес.
Если компания может пережить потерю данных за рабочий день, ночного копирования, возможно, хватит, чтобы уложиться в ее RPO. Но при трех условиях: копия действительно делается, хранится отдельно и из нее получается восстановиться.
Если же каждая пропавшая операция оборачивается упущенной выручкой, ошибкой в заказе или кассовым разрывом, копировать нужно чаще, например несколько раз в день или даже раз в час.
Поэтому начинать стоит не с привычного расписания бэкапа. Сначала договоритесь, какой объем данных бизнес готов потерять и сколько он продержится без конкретной системы. Потом сверьте с этим фактические возможности ИТ.
Шесть шагов теста восстановления
Проводит тест штатный администратор или ИТ-подрядчик. Задача собственника, руководителя или ответственного сотрудника — четко сформулировать задание и получить измеримый результат.
1. Возьмите одну критичную систему
Всю инфраструктуру за раз не проверить, и пытаться не нужно. Выберите сервис, без которого компания уже завтра утром не сможет нормально работать.
Обычно это:
- 1С;
- почта;
- файловый сервер, где лежат договоры, сметы или проектная документация;
- CRM;
- учетная система для производства, склада или продаж;
- касса или торговая система.
Одна система на один тест: так результат получится внятным, а работа уложится в день.
2. Используйте копию из отдельного хранилища
Копия рядом с рабочими данными для теста не годится.
Резервной копии нужно свое место: другой сервер, облако, отчуждаемый носитель, другой дата-центр. Если единственная копия лежит на том же диске, что и база 1С или файловый архив, первую проблему вы уже нашли.
На практике сверяйтесь с правилом 3-2-1:
- не меньше трех копий данных;
- носители как минимум двух типов;
- хотя бы одна копия за пределами основной площадки.
Против шифровальщиков заведите хотя бы одну неизменяемую копию. Ее не удалить и не зашифровать с обычной учетной записи администратора из рабочей инфраструктуры.
3. Восстановите систему в стороне от рабочей среды
Копию разворачивают на отдельной виртуальной машине, тестовом сервере или в изолированном контуре.
Рабочие системы на время проверки не трогают. Восстанавливать «поверх» действующей базы или рабочего сервера нельзя, даже если процедура выглядит безопасной.
В изоляции тест проходит спокойно и не превращается в новый инцидент.
4. Убедитесь, что в восстановленной системе можно работать
Распакованного архива или запущенной службы мало.
Пройдите сценарий, похожий на обычный рабочий день:
- сотрудник заходит под своей учетной записью;
- 1С открывает базу;
- документы последнего рабочего дня никуда не пропали;
- отчет строится;
- справочники, без которых не обойтись, открываются;
- нужные интеграции отвечают, либо ясно, какие из них поднимать отдельно;
- дата последних данных совпадает с ожидаемой точкой восстановления.
Последний пункт не пропускайте: по нему виден фактический RPO, то есть сколько данных пропадет при аварии.
5. Замерьте время
Начинайте отсчет по команде «начинаем восстановление» и останавливайте его, когда сотрудники уже проводят в системе рабочие операции.
Получится фактический RTO: время, за которое сервис возвращается в работу.
6. Сравните результат с тем, что нужно бизнесу
Итог уместите на одну страницу:
- когда проводили тест;
- какую систему проверяли;
- из какой копии восстанавливали и когда она сделана;
- сколько времени на самом деле заняло восстановление;
- сколько данных потеряли;
- сколько бизнес готов ждать и сколько данных готов потерять;
- что не сработало;
- кто проводил тест;
- что сделать до следующей проверки.
Если восстановление идет дольше, чем бизнес может ждать, виноватого искать не нужно. Это конкретный риск, его можно обсудить и закрыть.
Что находит первый тест
Без замечаний первый тест проходит редко, и это нормально: он для того и нужен, чтобы слабые места проявились до аварии.
Чаще всего находится что-то из этого списка.
Копия лежит рядом с данными. Резервные копии хранятся на том же сервере или дисковом массиве, что и рабочая база. Выйдет сервер из строя или вирус зашифрует данные, и пропадет все: база вместе с копиями. Восстанавливаться станет не из чего.
Копии нет или она повреждена. Отчет показывает, что задание выполнено, а файл пустой, неполный или не открывается. Узнать это можно одним способом — попробовать восстановиться. Лучше на тесте, чем в разгар аварии.
Копия слишком старая. Технически система поднимается, но данных теряется больше, чем компания может себе позволить. Скажем, для компании потеря операций за целый день уже слишком дорога, а базу 1С копируют раз в сутки по ночам. Сломается сервер в шесть вечера, и копия вернет состояние прошлой ночи, а накладные, оплаты и заказы за день придется вносить заново вручную.
Восстановление слишком долгое. Бизнес ждет, что 1С или кассы заработают через час, а загрузка копии, запуск и проверка данных растягиваются на несколько часов. Все это время сотрудники не отгружают товар и не выставляют счета.
Нет описания зависимостей и порядка запуска. Каждая система по отдельности поднимается, но без соседних не работает, и никто не знает, какую запускать первой. Например, 1С из копии запустилась, но не видит сервер лицензий и домен, а обмен с банком не идет. Формально система работает, но ни платеж, ни отгрузку не провести, пока не поднимут все, от чего она зависит.
Процедуру знает один человек. Восстановить систему умеет только администратор. Ушел в отпуск, заболел или уволился, и команда остается без инструкции, паролей и понимания, откуда начинать.
Когда одна система прошла тест, переходите ко второму этапу: проверьте восстановление уже не одного сервера, а минимального набора сервисов, без которого бизнес не работает.
На этом этапе и становится ясно, в какой последовательности поднимать инфраструктуру. Когда систем десятки, «по алфавиту» их не восстанавливают: нужны приоритеты и карта зависимостей.
Как часто тестировать и кто за это отвечает
Разумный минимум для критичных систем — один тест раз в полугодие. Если инфраструктура часто меняется — добавляются интеграции, переходят на другую схему авторизации или способ копирования, — проверять нужно чаще.
Тест, проведенный год назад, не гарантирует, что сценарий сработает сегодня. За год могли поменяться:
- серверы и среда виртуализации;
- версии 1С, СУБД, операционных систем;
- учетные записи и пароли;
- настройки сети;
- лицензии;
- интеграции с банками, кассами, CRM, внешними сервисами;
- перечень критичных систем.
Отвечать за тест должен конкретный человек, а не «ИТ» вообще. Это может быть внутренний администратор, руководитель ИТ, подрядчик или сотрудник со стороны бизнеса, который ставит задачу и принимает результат.
Журнал тестов нужен, но простой. Достаточно записывать:
- дату теста;
- систему;
- дату проверенной копии;
- фактические RPO и RTO;
- какие проблемы нашлись;
- кто ответственный;
- к какому сроку исправить;
- когда проверить повторно.
Через год такой журнал покажет состояние ИТ-инфраструктуры честнее, чем уверения, что «бэкапы настроены».
Если тест провалился
Неудачный тест еще не повод срочно менять систему резервного копирования или заказывать большой аудит. Для начала закройте базовые риски.
Первые четыре шага:
- Выделите для резервных копий отдельное хранилище, чтобы данные и копии не пропали разом.
- Напишите короткий регламент: что копируем, куда и с какой частотой, кто отвечает, сколько данных бизнес готов потерять, когда проводим тест.
- Опишите, в каком порядке восстанавливать системы, как они зависят друг от друга, какие нужны доступы и кто за что отвечает.
- После изменений повторите тест, а не ограничивайтесь проверкой настроек в консоли.
В производственной компании, в которой около 200 сотрудников, после внешней диагностики внедрили регламент проверки своими силами, без аудита, примерно за два месяца. Главное здесь — записать найденные проблемы и назначить ответственных.
Внешняя проверка пригодится в двух ситуациях. Первая: вы не знаете, проводили ли тест, и не можете судить, насколько точно ИТ описывает состояние инфраструктуры.
Вторая: тест не прошел, но по результатам непонятно, где причина: в настройках копирования, в инфраструктуре, в доступах или в зависимостях между системами.
Для первой ситуации достаточно короткой диагностики: интервью с бизнесом и ИТ-специалистами, разбор ключевых рисков и отчет без технического жаргона. Для второй нужен ИТ-аудит с доступом к серверам, логам, системе резервного копирования и настройкам инфраструктуры. Он ищет корневую причину, а не только фиксирует симптом.
Проверить до аварии
Резервная копия работает как мотоциклетный шлем. На ровной дороге о нем не думают, но застежку и размер проверяют в гараже, а не во время падения.
Возьмите одну критичную систему. Разверните ее в стороне от рабочей среды. Убедитесь, что сотрудники могут в ней работать. Замерьте время.
День, потраченный на тест, скажет о готовности к аварии больше, чем год зеленых галочек в отчетах о копировании.
Остальные зоны ИТ, кроме резервных копий, собственник может проверить по чек-листу из семи пунктов: я разбирал его в статье «ИТ-инфраструктура „вроде работает“: как собственнику понять, в каком она состоянии».
Другие разборы из практики поддержки бизнеса выходят в Telegram-канале ALP ITSM.
