


ИИ для кода в 2026 году: 12 лучших нейросетей для программирования — бесплатные и платные
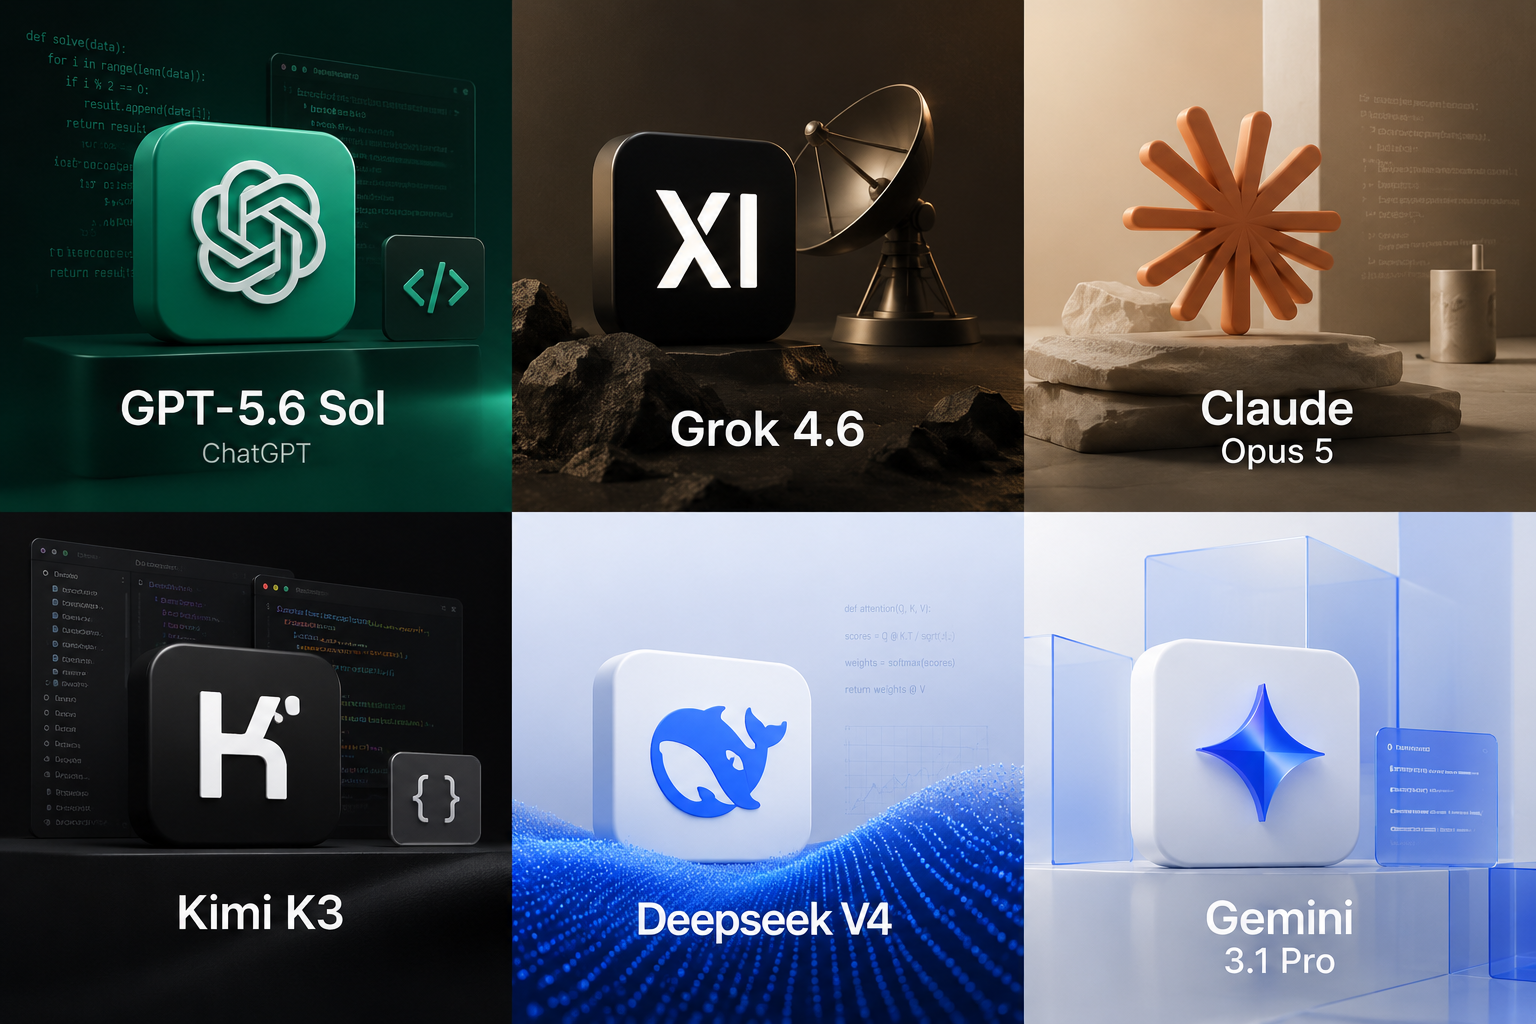
Для этого рейтинга я сравнил актуальные ИИ для кода, специализированные инструменты для программистов и несколько бесплатных вариантов. Шесть флагманских моделей дополнительно прошли один и тот же практический тест: им дали асинхронный Python-сервис с ошибками в бизнес-логике, безопасности и конкурентном доступе и попросили провести полноценный code review. Поэтому ниже будет не только перечень возможностей, но и реальные различия между ChatGPT, Claude, Gemini, Kimi, Grok и DeepSeek.
Материал актуализирован 21 августа 2026 года.
Какой ИИ лучше пишет код (TL;DR)
Одного абсолютного победителя для всех сценариев нет. Чат-модель, coding-agent и AI-IDE решают разные задачи. Но если не хочется разбираться во всем рейтинге, я бы выбирал так:
- ChatGPT GPT-5.6 Sol — самый универсальный вариант для генерации, анализа, отладки и рефакторинга кода.
- Claude Opus 5 — когда нужно глубоко разобраться в существующем проекте, найти неочевидный баг или спланировать большое изменение.
- Gemini 3.1 Pro — сильный вариант для сложного reasoning, анализа кода и работы с экосистемой Google.
- OpenAI Codex — если нужен не совет в чате, а coding-agent, который сам работает с файлами, кодовой базой и многошаговыми задачами.
- Kimi K3 — если критичен большой контекст и нужно анализировать крупную кодовую базу или длинную инженерную задачу.
- DeepSeek V4 Lite — один из наиболее интересных вариантов, если нужна нейросеть для кода бесплатно.
- Cursor — для постоянной работы с ИИ непосредственно внутри редактора кода и всего проекта.
- Google Antigravity — сильный бесплатный вариант среди агентных инструментов для программирования (требуется привязка карты).
Модель и инструмент — не одно и то же. ChatGPT, Claude, Gemini, Kimi и DeepSeek — это нейросети, которым можно поручить написание, анализ или исправление кода. Cursor работает как AI-редактор, а Codex и Antigravity относятся к агентному подходу: они могут работать сразу с файлами проекта и выполнять последовательность действий. Поэтому ниже я сравниваю не только «кто лучше пишет код», но и для какой задачи лучше подходит каждый ИИ для программирования.
В первой таблице собраны основные варианты с учетом типа инструмента, сильных сторон и наличия бесплатного доступа. А шесть флагманских моделей — ChatGPT, Claude, Gemini, Kimi, Grok и DeepSeek — я дополнительно проверил на одном и том же Python-коде с заранее заложенными ошибками. Результаты этого теста и методику оценки разберу ниже.
Лучшие ИИ для кода в 2026 году
Что мы тестировали: ChatGPT против Claude, Gemini, Kimi, Grok и DeepSeek
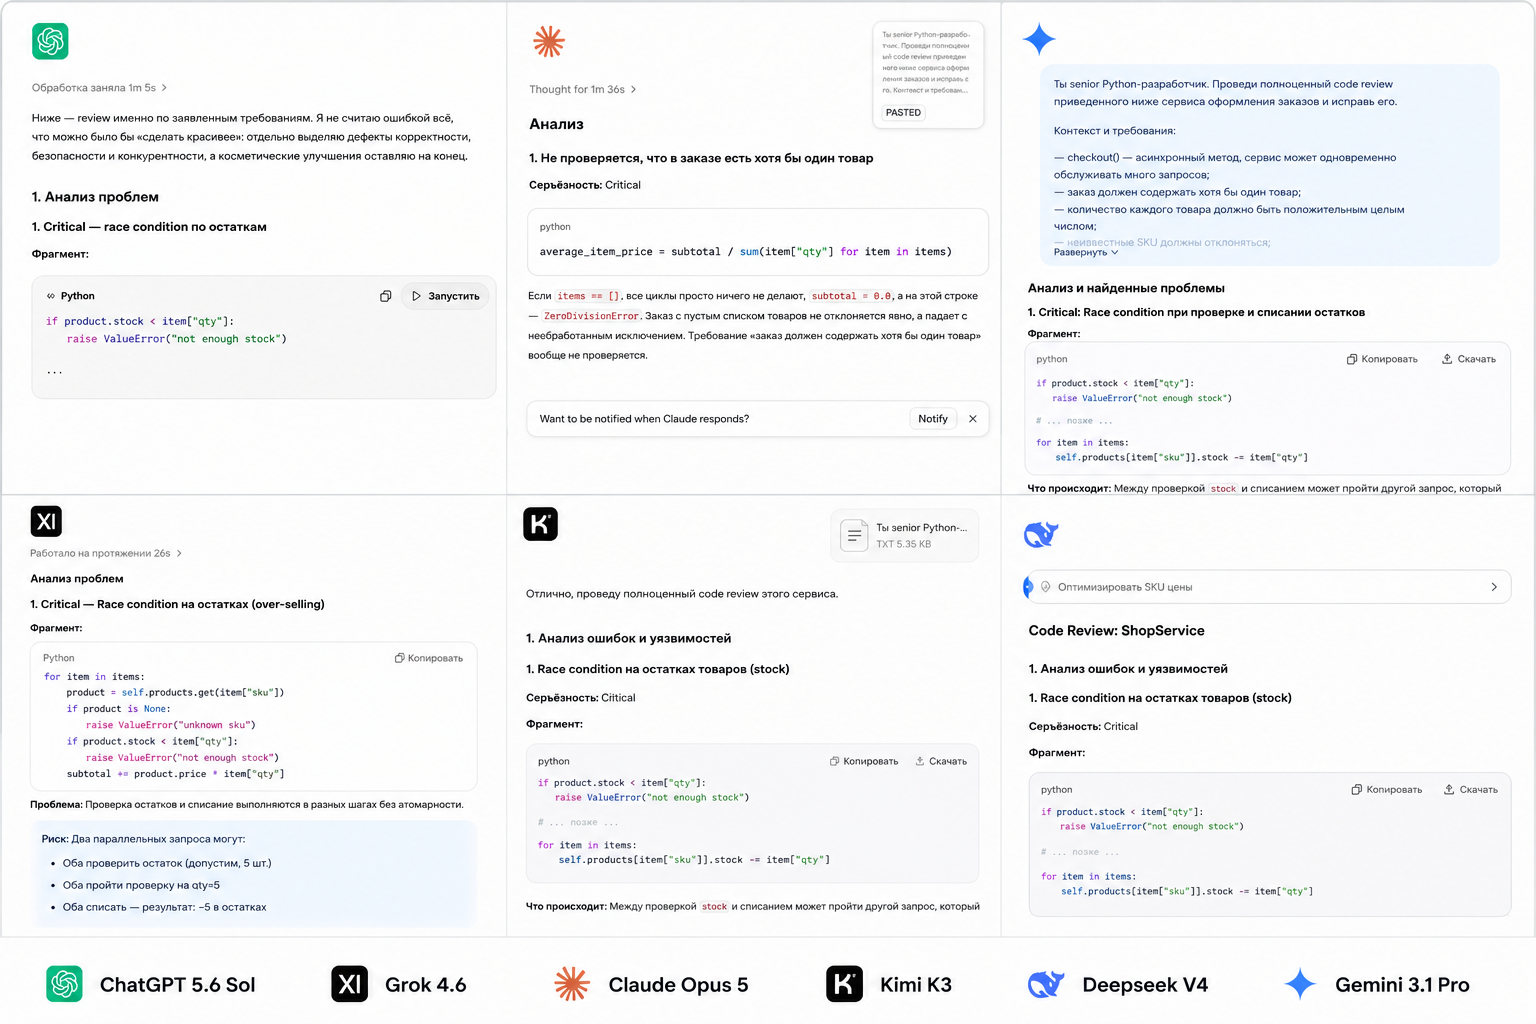
Чтобы рейтинг не состоял только из характеристик разработчиков, я отдельно проверил шесть моделей на одной задаче. Это не синтетическая головоломка на написание функции, а небольшой сервис оформления заказов на Python, похожий на фрагмент реального backend-кода.
В исходнике были специально оставлены проблемы разных типов:
- Race condition при конкурентном списании остатков.
- Race condition при одновременном использовании одноразового купона.
- Отсутствие проверки купона по списку разрешенных.
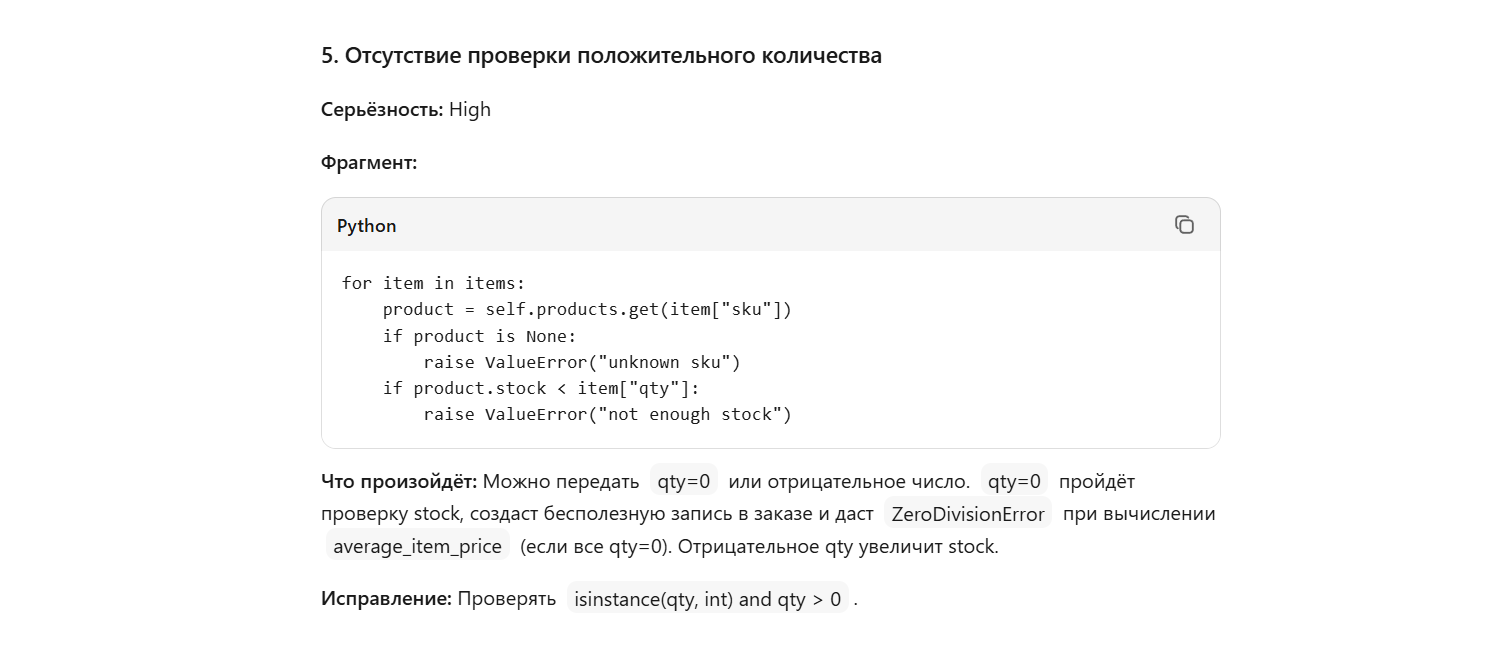
- Отсутствие корректной валидации количества товара.
- Пустой заказ с последующим ZeroDivisionError.
- IDOR — пользователь мог прочитать чужой заказ.
- Блокирующий time.sleep() внутри асинхронного метода.
- Квадратичная проверка дубликатов SKU за O(n²).
Каждая модель получила один и тот же промпт в новом диалоге. Веб-поиск и выполнение кода запрещались. Нужно было самостоятельно провести code review, расставить серьезность проблем, исправить сервис и написать минимальный набор автоматических тестов.
Промпт, который использовался в тестеИсходный код с заложенными ошибками
Условия тестирования
Чтобы сравнение было максимально одинаковым, все шесть моделей получили один и тот же исходный код и один и тот же промпт. Для каждой использовался новый диалог без предыдущего контекста; моделям было запрещено запускать код и обращаться к веб-поиску. Я оценивал только первый полный ответ — без уточняющих сообщений и просьб исправить результат после замечаний.
- Модели: GPT-5.6 Sol, Gemini 3.1 Pro, Claude Opus 5, Grok 4.6, Kimi K3 и DeepSeek V4 Lite.
- Дата теста: 21 августа 2026 года.
- Задача: Code review и исправление одного Python-сервиса.
- Условия: Один промпт, одинаковый исходник, новый диалог для каждой модели.
- Дополнительные возможности: Веб-поиск и выполнение кода отключены.
- Количество заранее заложенных основных дефектов: 8.
Эталон содержал 8 заранее известных основных дефектов. Я зафиксировал их и систему оценки до сравнения ответов, чтобы итоговый балл не подгонялся под понравившуюся модель. При этом нейросеть могла найти дополнительные реальные проблемы — за них я не добавлял баллы к основной восьмерке, но учитывал как показатель качества анализа.
Оценка состояла из четырех частей: обнаружение дефектов — 40 баллов, качество исправленного кода — 36, автоматические тесты — 16 и инженерное качество ответа — 8. За каждую придуманную проблему уровня Critical или High, которой в исходнике фактически не было, предусматривался штраф в 3 балла.
Тест не сильно сложный, но достаточно показательный для рядовых задач. На поверхности модели выступили очень близко: почти все увидели очевидные проблемы с остатками, правами доступа, количеством товаров и блокировкой event loop. Настоящая разница появилась после фразы «исправь код».
ChatGPT 5.6
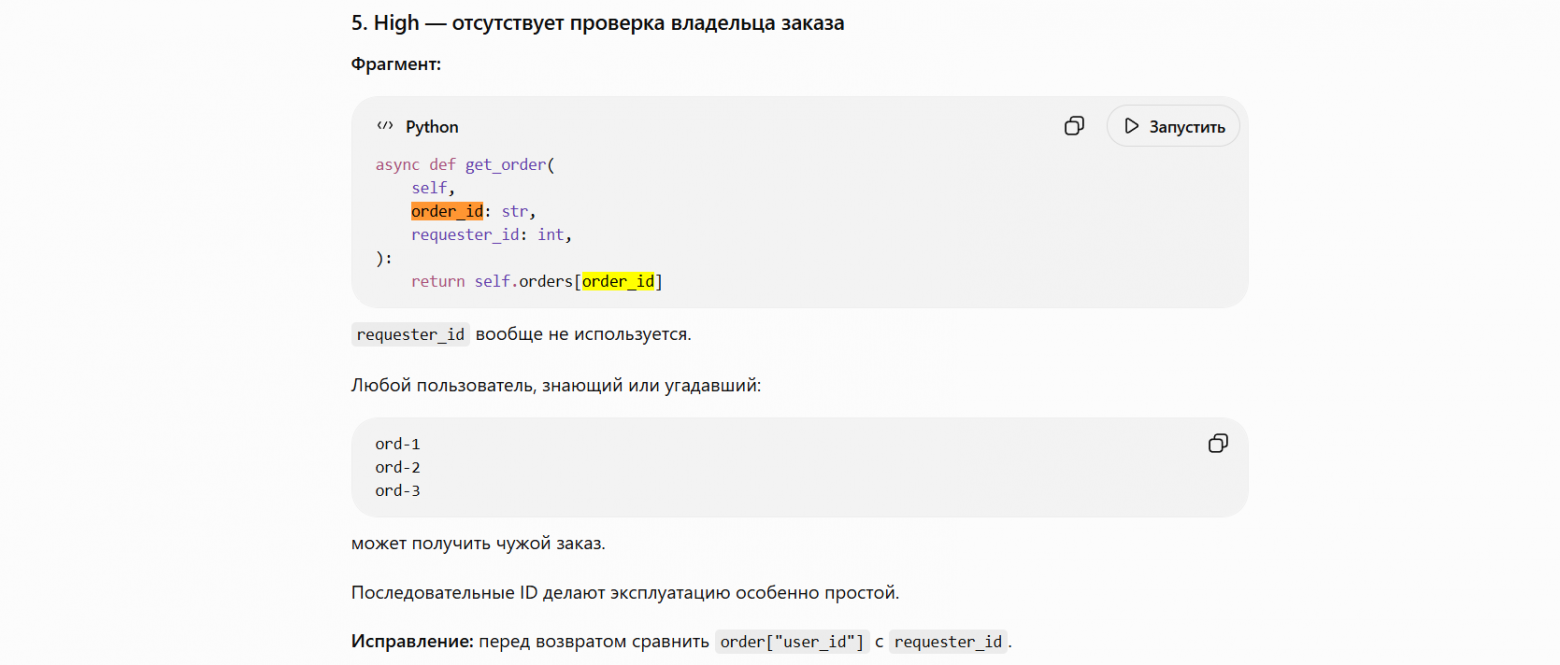
GPT-5.6 Sol лучше остальных отделял реальные дефекты от предположений. Например, модель специально отметила, что генерацию order_id = len(self.orders) + 1 нельзя автоматически называть доказанной asyncio race condition: между вычислением ID и записью в словарь в исходном фрагменте нет await. Еще одна мелочь, которую поймали только самые внимательные ответы, — bool в Python является подклассом int, поэтому простая проверка isinstance(True, int) возвращает True.
Один из показательных моментов — проверка количества товара. ChatGPT отдельно учел особенность Python: bool является подклассом int, поэтому обычной проверки isinstance(qty, int) недостаточно: if ( isinstance(qty, bool) or not isinstance(qty, int) or qty <= 0 ): raise ValueError("qty must be a positive integer")Объяснить с
Gemini 3.1 Pro
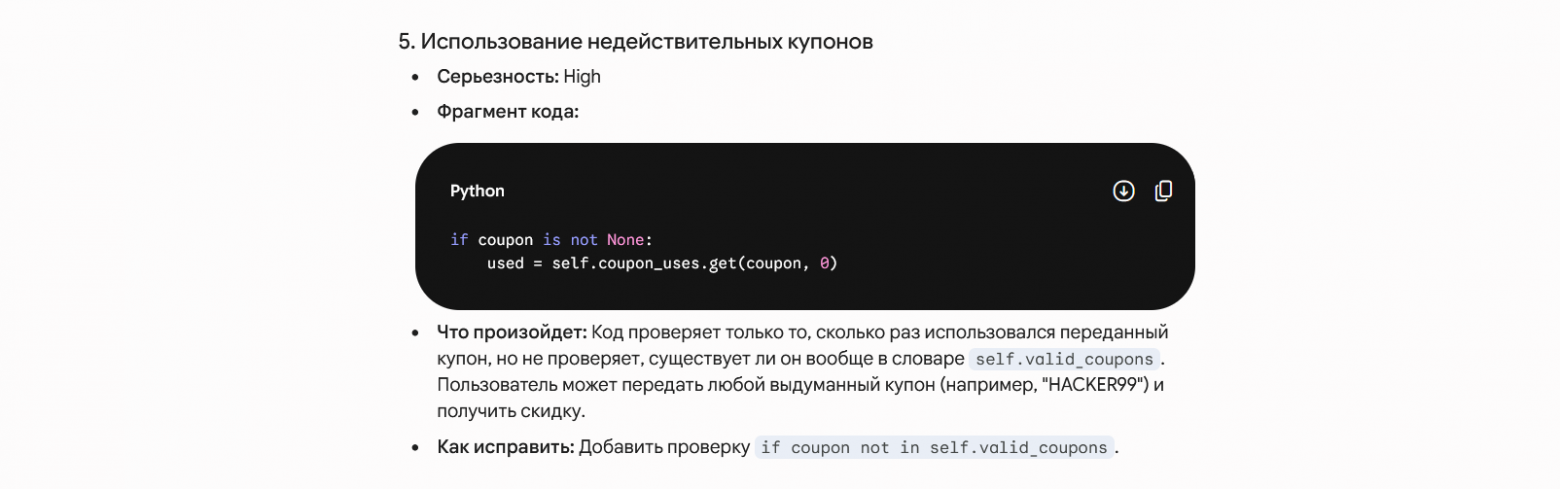
Gemini 3.1 Pro оказался почти безошибочным и дал очень сбалансированный фикс: критическая секция была короткой, а долгие операции не удерживали глобальную блокировку. Это важно для асинхронного сервиса, который должен параллельно обслуживать много запросов.
Gemini удачно ограничил критическую секцию только операциями с общим состоянием: проверкой stock и купона, списанием остатков и созданием заказа. Долгие асинхронные операции выполнялись уже вне asyncio.Lock, поэтому независимые checkout не блокировали друг друга без необходимости.
Claude Opus 5
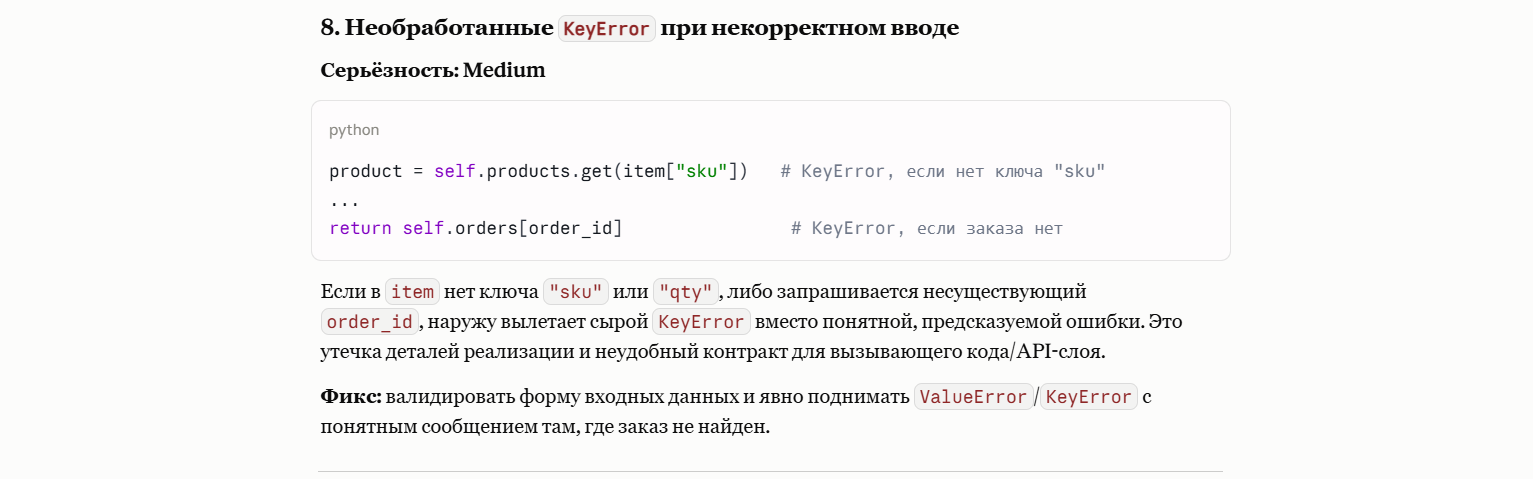
Claude Opus 5 отлично нашел все ошибки и написал хорошие regression-тесты, однако оставил несколько await внутри общего asyncio.Lock. Данные становятся корректными, но независимые заказы дольше ждут друг друга. То есть решение безопасное, но не оптимальное по конкурентности.
Grok 4.6
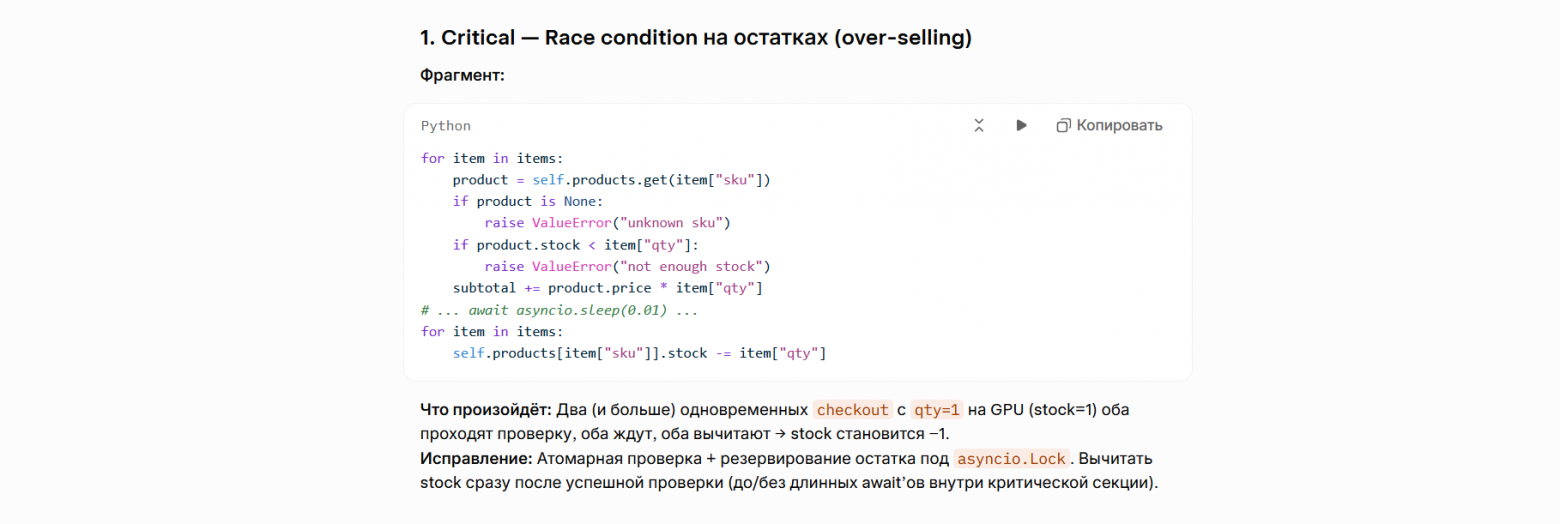
Grok 4.6 хорошо исправил сам сервис, но для race condition купона написал обычный последовательный тест. Такой тест доказывает, что второй вызов купона запрещен, но не воспроизводит исходный сценарий, когда два запроса одновременно читают одно и то же состояние.
Kimi K3
Kimi K3 также нашел все основные дефекты и подготовил конкурентные тесты, но, как и Claude, удерживал глобальный lock дольше необходимого.
Deepseek V4
Самая показательная ошибка получилась у DeepSeek V4 Lite: в исправленной версии купон резервировался до финальной проверки наличия товара. В итоге неуспешный заказ мог «сжечь» одноразовый купон. Это хороший пример того, почему сгенерированный ИИ код нельзя принимать только потому, что он выглядит аккуратно.
У DeepSeek обнаружился обратный пример: исправление создало новый побочный эффект. Модель сначала резервировала одноразовый купон: async with self._coupon_lock: if self.coupon_uses.get(coupon, False): raise ValueError("coupon exhausted") self.coupon_uses[coupon] = TrueОбъяснить с
и лишь затем проверяла наличие товара под другой lock. Поэтому заказ мог не состояться из-за недостатка stock, но купон уже считался использованным.
Важно: этот эксперимент не доказывает, что одна модель «лучше программирует вообще». Мы проверяли конкретный сценарий: code review, debugging, конкурентность и исправление небольшого Python-сервиса. На frontend, SQL, Java или длинной агентной задаче порядок может быть другим.
ТОП-12 нейросетей и ИИ для программирования
1. ChatGPT GPT-5.6 Sol — лучший универсальный ИИ для кода
GPT-5.6 Sol — флагманская reasoning-модель OpenAI и мой первый выбор, когда нужен один универсальный ИИ для программирования. Она подходит для написания функций и модулей с нуля, debugging, объяснения чужого кода, рефакторинга, code review, тестов и архитектурных вопросов.
В нашем Python-тесте ChatGPT не просто нашел все заложенные ошибки. Он хорошо расставил приоритеты, не стал записывать в критические баги все потенциальные улучшения и отдельно заметил тонкости, которые другие модели пропустили. В частности, модель корректно обработала bool при проверке целого количества и аккуратно рассуждала о том, где в asyncio действительно возможна гонка, а где переключения корутины нет.
- Сильные стороны: Универсальность, качественный debugging, работа с async-кодом, хорошее понимание требований, сильный code review.
- Подходит для: Python, JavaScript/TypeScript, backend, frontend, SQL, алгоритмов, API, тестирования и рефакторинга.
- Ограничения: GPT-5.6 Sol относится к платным флагманским моделям; для больших агентных задач удобнее использовать ее внутри Codex.
Если нужен ChatGPT именно для работы с кодом из браузера, GPT-5.6 Sol можно запустить через Study24. В нашем тесте использовалась именно эта модель.
2. Claude Opus 5 — для сложного debugging и больших проектов
Claude Opus 5 — актуальная модель Anthropic из старшей линейки Opus. Она особенно интересна не для простого запроса «напиши функцию сортировки», а для задач, где сначала нужно понять существующую систему: прочитать несколько связанных модулей, проследить поток данных, найти причину бага и предложить минимальные изменения.
Anthropic отдельно делает акцент на software engineering, долгих многошаговых задачах и способности Opus 5 проверять собственную работу. Это совпало и с нашим тестом: Claude нашел все основные дефекты, заметил Python-edge case с bool и подготовил хорошие конкурентные тесты.
Главный минус конкретного ответа в benchmark — слишком широкий asyncio.Lock. Claude обеспечил корректность, но оставил медленные операции внутри критической секции. Для учебного примера это не ломает результат, а в нагруженном сервисе снижает параллелизм.
- Сильные стороны: Анализ больших изменений, debugging, root-cause analysis, аккуратный рефакторинг, объяснение архитектуры.
- Подходит для: Больших backend-проектов, legacy-кода, сложных багов, PR review и планирования изменений.
- Ограничения: Флагманская модель платная; при простых задачах ее возможности могут быть избыточны.
3. Gemini 3.1 Pro — сильный reasoning и почти идеальный результат теста
Gemini 3.1 Pro — одна из самых сильных моделей Google для сложных reasoning-задач. Для программирования она интересна качественным анализом, интеграцией с инструментами Google и возможностью работать в агентных сценариях через Antigravity.
В нашем тесте Gemini набрал 98 из 100 баллов. Он обнаружил все основные ошибки, сделал check-and-mutate операции атомарными, вынес медленные операции за пределы lock и написал настоящие конкурентные тесты на overselling и повторное использование купона.
На практике Gemini удобно использовать для анализа кода, генерации решений по подробному техническому заданию, работы с API Google, Android-разработки и задач, где нужно соединить программирование с большим объемом дополнительного контекста.
- Сильные стороны: Reasoning, анализ сложных условий, качественный исправленный код, экосистема Google.
- Подходит для: Python, Java, Android, backend, анализ больших технических материалов.
- Ограничения: Экосистема инструментов Google в 2026 году изменилась: индивидуальных пользователей старого Gemini Code Assist и Gemini CLI переводят на Antigravity.
4. OpenAI Codex — когда нужен не чат, а полноценный coding-agent
OpenAI Codex стоит отделять от обычного ChatGPT. GPT-5.6 Sol — это прежде всего модель, которой можно дать задачу и получить анализ или код. Codex — агентная среда для полноценной инженерной работы.
Агент может работать с репозиторием, менять файлы, выполнять многошаговые задачи, заниматься рефакторингом, миграциями и подготовкой pull request. Современный Codex также рассчитан на параллельную работу нескольких агентов и более длинные workflow.
Типичный сценарий выглядит уже не так: Напиши функцию validate_user()Объяснить с
а скорее так: Изучи модуль авторизации. Найди причину, по которой refresh token иногда перестает работать. Добавь regression-тест. Исправь проблему, не меняя публичный API.Объяснить с
Если регулярно работаете с существующим проектом, coding-agent обычно полезнее отдельного чат-бота.
5. Kimi K3 — ИИ для больших репозиториев и длинных инженерных сессий
Kimi K3 — одна из наиболее интересных open-weight моделей 2026 года. Moonshot AI заявляет 2,8 трлн параметров, около 104 млрд активных параметров за токен и контекст до 1 048 576 токенов.
Главный сценарий Kimi K3 — long-horizon coding: длинные инженерные сессии, навигация по большим репозиториям и агентная работа с инструментами. Поэтому модель интереснее всего выглядит там, где обычный чат быстро начинает терять контекст.
В нашем небольшом benchmark Kimi нашел все основные ошибки и набрал 94/100. Основной минус был не в понимании кода, а в архитектуре предложенного исправления: глобальная блокировка удерживалась дольше, чем было необходимо.
- Сильные стороны: Огромный контекст, long-horizon coding, открытые веса, работа с крупными проектами.
- Подходит для: Больших репозиториев, анализа нескольких модулей, агентных задач и экспериментов с open-weight моделями.
- Ограничения: Максимальный теоретический контекст не означает, что каждый интерфейс и провайдер даст использовать весь миллион токенов в любом режиме.
6. Grok 4.6 — свежий флагман для agentic coding
Grok 4.6 — один из самых свежих участников рейтинга: модель вышла 12 августа 2026 года. Основной акцент xAI делает на длинных агентных задачах, работе по codebase и превращении идеи в готовое приложение.
В нашем тесте Grok нашел все основные дефекты и подготовил качественно исправленный сервис. Потеря баллов произошла на тестах: race condition купона модель поняла и исправила, но regression-тест проверял повторное использование последовательно, а не двумя конкурентными запросами.
Это не делает модель плохой — наоборот, итог 95/100 оказался очень высоким. Но пример хорошо показывает, что даже правильное объяснение проблемы не гарантирует хороший автоматический тест.
- Сильные стороны: Agentic coding, веб-приложения, работа по codebase, сильные современные coding-бенчмарки.
- Интеграции: Grok 4.6 доступен в Grok Build, Cursor и GitHub Copilot.
- Кому подойдет: Разработчикам, которым нужен еще один современный флагман рядом с Claude, GPT и Gemini.
7. DeepSeek V4 Lite — бесплатная нейросеть для написания кода
DeepSeek V4 Lite — бесплатный вариант, доступный в используемом мной агрегаторе. Название важно не путать с официальными моделями DeepSeek: сама компания в 2026 году выпускает семейство DeepSeek-V4-Pro и DeepSeek-V4-Flash, обе с контекстом до 1 млн токенов.
DeepSeek остается интересным прежде всего сочетанием возможностей и стоимости. Если нужно бесплатно объяснить фрагмент Python, помочь написать SQL-запрос, создать небольшую функцию или найти относительно очевидную ошибку, начинать с него вполне разумно.
В сложном code review разница с лидерами стала заметнее. В нашем тесте DeepSeek набрал 87/100 и допустил новый бизнес-баг: одноразовый купон отмечался использованным до окончательной проверки возможности оформить заказ. То есть код выглядел логично, но нарушал транзакционную целостность.
- Сильные стороны: Бесплатный доступ, хороший базовый coding, длинный контекст семейства V4.
- Подходит для: Обучения, небольших скриптов, объяснения кода, повседневных несложных задач.
- Ограничения: На сложном рефакторинге и конкурентной бизнес-логике результат нужно проверять особенно внимательно.
8. Cursor — один из лучших AI-редакторов для постоянной разработки
Cursor — уже не просто VS Code с чат-ботом сбоку. Это полноценный AI-редактор, в котором агент видит файлы проекта, может искать зависимости, менять несколько участков кода и работать с терминалом.
Основное преимущество Cursor перед обычным чатом — контекст проекта постоянно находится рядом. Не нужно каждый раз копировать пять файлов в новый диалог или объяснять структуру директорий. Особенно хорошо формат работает при последовательной разработке одного продукта.
- Сильные стороны: Agent mode, работа со всей codebase, автодополнение, terminal, поддержка разных frontier-моделей.
- Бесплатно: Есть тариф Hobby без банковской карты, но количество agent-запросов и Tab completions ограничено.
- Кому подойдет: Тем, кто пишет код каждый день и хочет встроить ИИ непосредственно в основной workflow.
Cursor я бы не ставил вместо GPT или Claude: это другой слой. Внутри AI-IDE все равно используется языковая модель. Поэтому правильнее выбирать сначала workflow, а затем модель внутри него.
9. GitHub Copilot — удобный бесплатный помощник внутри IDE
GitHub Copilot остается одним из самых понятных способов добавить ИИ непосредственно в процесс написания кода. Его сильная сторона — не отдельный длинный ответ, а постоянная помощь: inline completions, чат, CLI, правки и агентные функции.
Для начинающих важен полноценный бесплатный тариф. На момент проверки Copilot Free дает до 2 000 автодополнений в месяц и 50 запросов в чат или agent mode. Банковская карта для Free не требуется.
- Сильные стороны: Интеграция с GitHub и VS Code, автодополнение, простой старт, выбор моделей на старших тарифах.
- Бесплатно: Да, но лимитированный Free-план.
- Кому подойдет: Тем, кому ИИ нужен постоянно рядом с курсором, а не для редких больших запросов.
10. Google Antigravity — один из лучших бесплатных вариантов 2026 года
Google Antigravity особенно интересен тем, кто ищет бесплатные ИИ для программирования не только в формате чата. Это agent-first платформа Google для разработки.
На индивидуальном тарифе стоимость составляет $0 в месяц. В него входят доступ к Gemini 3.5 Flash, Gemini 3.1 Pro и ряду других моделей, безлимитные Tab completions и Command requests, но действуют базовые недельные rate limits.
Этот пункт особенно важен в 2026 году из-за изменения экосистемы Google. С 18 июня старые Gemini Code Assist IDE Extensions и Gemini CLI перестали обслуживать индивидуальные тарифы, Google AI Pro и AI Ultra в прежнем формате. Пользователей переводят именно на Antigravity и Antigravity CLI.
- Сильные стороны: Бесплатный individual-план, модели Gemini, agentic workflow, CLI.
- Подходит для: Разработчиков, которым нужен бесплатный агентный инструмент, а не только чат.
- Ограничения: На бесплатном тарифе есть недельные лимиты.
11. Windsurf — альтернатива Cursor с бесплатным тарифом
Windsurf — еще одна AI-IDE, построенная вокруг агентного взаимодействия с кодовой базой. Основной интерфейс Cascade умеет работать с проектом, вносить изменения и использовать инструменты, а Windsurf Tab отвечает за быстрые продолжения кода.
У сервиса есть бесплатный тариф. По опубликованным условиям он включает ограниченное количество premium prompt credits, при этом Windsurf Tab можно использовать без жесткого лимита, а часть моделей продолжает работать без расходования платных кредитов.
Выбирать между Cursor и Windsurf лучше не по рейтингу в интернете, а по собственному проекту. Интерфейсы похожи по назначению, и через несколько дней реальной работы обычно становится понятно, где меньше приходится исправлять действия агента вручную.
12. JetBrains Junie — coding-agent для профессиональных IDE
Junie особенно интересен разработчикам, которые уже работают в IntelliJ IDEA, PyCharm и других IDE JetBrains. В 2026 году агент вышел из beta и стал гораздо больше похож на самостоятельного разработчика внутри IDE.
Junie умеет сначала составить план, затем выполнить изменения, запускать тесты, пользоваться настоящим debugger IDE и проводить review с учетом контекста проекта. Есть CLI, поддержка BYOK и возможность подключать локальные модели.
- Сильные стороны: Глубокая интеграция с IDE JetBrains, debugger, project index, тестовые конфигурации, code review.
- Особенно интересен для: Java, Kotlin, Python и больших корпоративных проектов.
- Плюс: Можно выбирать LLM, а не быть жестко привязанным к одной модели.
Лучшие бесплатные нейросети для программирования
Запрос «нейросеть для кода бесплатно» немного сложнее, чем кажется. У одних сервисов действительно есть постоянный бесплатный тариф, другие дают небольшие лимиты, а третьи бесплатно предоставляют только более слабую модель. Поэтому правильнее разделять «полностью бесплатно» и «можно начать без оплаты».
Если нужна именно бесплатная нейросеть для написания кода в браузере, проще начать с DeepSeek. Если нужен ИИ прямо в редакторе — с Copilot Free. Если хочется попробовать полноценный coding-agent — с Antigravity.
Чат, AI-IDE или coding-agent — что лучше для программирования
Одна из причин путаницы в рейтингах — в одну таблицу часто ставят ChatGPT, Cursor и Copilot, хотя это продукты разных классов.
Для одного сложного вопроса покупать отдельную AI-IDE необязательно: часто быстрее открыть Claude или ChatGPT. Но когда работа идет с проектом несколько часов ежедневно, возможность агента видеть структуру репозитория и самостоятельно читать необходимые файлы экономит намного больше времени, чем «самая умная модель» в изолированном чате.
Какой ИИ выбрать для Python, JavaScript, Java, C++, SQL и 1С
Большинство флагманских моделей знает популярные языки программирования, поэтому жесткого правила «Claude для Python, а GPT для JavaScript» нет. Но исходя из возможностей инструментов я бы распределил задачи так:
Для редкого фреймворка или внутреннего API важнее не название модели, а контекст. Дайте ИИ документацию, версии зависимостей, структуру проекта и пример правильного кода — результат обычно улучшается сильнее, чем после простой замены одного флагмана на другой.
ИИ для проверки, анализа и исправления кода
Нейросеть для кода полезна не только тогда, когда нужно создать программу с нуля. В реальной разработке один из наиболее сильных сценариев — работа с уже существующим кодом.
ИИ можно поручить:
- Найти ошибку и объяснить конкретный сценарий, при котором она возникает.
- Провести code review и разделить реальные дефекты и необязательные улучшения.
- Найти race condition в асинхронном или многопоточном коде.
- Проверить безопасность — права доступа, валидацию, SQL injection, утечки данных.
- Объяснить legacy-код и восстановить его бизнес-логику.
- Провести рефакторинг без изменения публичного API.
- Написать unit-тесты и regression-тесты на найденные ошибки.
- Оптимизировать производительность, если сначала указать реальные ограничения и профиль нагрузки.
Лучше всего просить модель не просто «найти ошибки», а требовать доказать каждую проблему конкретным сценарием. Иначе LLM нередко начинает добавлять к списку все потенциальные best practices — даже когда они не являются дефектами исходного кода.
ИИ-агенты для программирования: зачем нужны Codex, Junie и Antigravity
Coding-agent отличается от обычной нейросети главным образом уровнем автономности. Чат отвечает на то, что вы ему отправили. Агент может самостоятельно определить, какие файлы открыть, выполнить команды, изменить проект, запустить тесты и повторить попытку после ошибки.
Например, обычному чату придется по очереди отправить:
- Текст ошибки.
- Главный модуль.
- Зависимый класс.
- Конфигурацию.
- Результаты тестов после исправления.
Coding-agent может получить задачу «исправь падение этого теста», сам пройти по зависимостям и выполнить большую часть цепочки.
Это не означает, что контроль разработчика больше не нужен. Чем больше файлов модель может менять самостоятельно, тем дороже становится ошибка. Для важных проектов я бы обязательно оставлял review diff, запуск тестов и проверку архитектурных изменений человеком.
А что выбрать для вайбкодинга
ИИ для кодинга и ИИ для вайбкодинга пересекаются, но пользовательские задачи разные. В этой статье речь в первую очередь о программировании: написать и проверить код, исправить баг, разобраться в репозитории, провести рефакторинг.
Вайбкодинг чаще подразумевает другой workflow: человек описывает приложение естественным языком, а ИИ берет на себя большую часть реализации. Здесь на первый план выходят полноценные агенты и сервисы для сборки приложений из промпта.
Как правильно попросить нейросеть написать код
Разница между посредственным и хорошим результатом часто определяется не «секретными промптами», а количеством технических ограничений, которые вы сообщили модели.
Промпт для написания кода с нуля
Ты senior Python-разработчик. Нужно реализовать REST API для [задача]. Требования: — Python 3.13; — FastAPI; — PostgreSQL; — Асинхронная работа с БД; — Публичные сигнатуры: [описание]; — Обработать edge cases: [список]; — Не добавлять зависимости без необходимости. Сначала кратко опиши решение. Затем покажи готовый код. После кода напиши минимальные unit-тесты.Объяснить сПромпт для поиска ошибки
Найди причину ошибки в коде ниже. Не переписывай программу целиком. Сначала объясни конкретный сценарий, при котором возникает проблема. Затем предложи минимальное исправление. Если для точного ответа не хватает контекста — перечисли, какие данные нужны. Не придумывай потенциальные проблемы, не связанные с текущей ошибкой.Объяснить сПромпт для code review
Проведи code review как senior-разработчик. Для каждой найденной проблемы укажи: 1. Серьезность: Critical / High / Medium / Low. 2. Конкретный фрагмент. 3. Что именно может произойти. 4. Как воспроизвести проблему. 5. Минимальное исправление. Отдельно раздели: — Реальные ошибки; — Безопасность; — Производительность; — Необязательные улучшения. Не увеличивай количество замечаний искусственно.Объяснить сМожно ли доверять коду, написанному нейросетью
Использовать ИИ для помощи с кодом можно и нужно, но модель не заменяет проверку. Наш тест хорошо это показал: даже сильные модели, которые правильно нашли race condition, иногда написали тест, не воспроизводящий эту гонку, или внесли побочный эффект при исправлении.
Для production-кода я бы придерживался нескольких правил:
- Не принимайте большой diff без review. Чем больше изменений сделал агент, тем выше вероятность незаметного изменения поведения.
- Просите regression-тест. Если ИИ утверждает, что нашел баг, тест должен падать на старом коде и проходить на исправленном.
- Проверяйте зависимости. Модель может помнить старый API библиотеки или придумать метод, которого нет.
- Не отправляйте секреты. API-ключи, пароли, приватные токены и production-конфигурацию нужно удалять из контекста.
- Особенно внимательно проверяйте безопасность и конкурентность. Такой код может выглядеть корректно на обычном happy path и ломаться только под нагрузкой.
Частые вопросы
Какой ИИ лучше всего пишет код в 2026 году?
Для универсальной работы я бы начал с GPT-5.6 Sol и Claude Opus 5. В нашем практическом Python code review GPT-5.6 Sol получил 100/100, Gemini 3.1 Pro — 98/100, Claude — 96/100. Но для постоянной работы с репозиторием удобнее использовать coding-agent или AI-IDE, например Codex или Cursor.
Какая нейросеть лучше для программирования бесплатно?
Для обычного чата можно начать с DeepSeek V4 Lite. Для IDE есть GitHub Copilot Free и Cursor Hobby, а Google Antigravity предлагает бесплатный individual-план с доступом к Gemini 3.1 Pro и другим моделям при наличии недельных лимитов.
Какой ИИ лучше для Python?
Для Python хорошо подходят GPT-5.6 Sol и Claude Opus 5, особенно если речь идет о backend, асинхронности, debugging и code review. В нашем тесте именно на Python все флагманы показали хорошие результаты, но лидерами стали GPT, Gemini и Claude.
Что лучше для программирования — ChatGPT или Claude?
ChatGPT GPT-5.6 Sol универсальнее и в нашем тесте немного лучше обработал инженерные тонкости. Claude Opus 5 особенно силен в глубоком анализе существующего кода, сложном debugging и больших многошаговых изменениях. На практике я использую оба: GPT как универсального помощника, Claude — когда нужно глубже разобраться в большой задаче.
Может ли нейросеть проверить и исправить чужой код?
Да. Это один из самых полезных сценариев. Модель может объяснить код, найти логические ошибки, уязвимости, проблемы производительности и предложить рефакторинг. Лучший результат получается, если вместе с кодом дать требования и попросить модель доказать каждую найденную проблему конкретным сценарием.
Что такое ИИ-агент для программирования?
Это инструмент, который не ограничивается текстовым ответом. Coding-agent может читать файлы проекта, пользоваться терминалом, менять код, запускать тесты и самостоятельно выполнять несколько этапов задачи. Примеры — OpenAI Codex, JetBrains Junie и Google Antigravity.
Можно ли написать сайт или приложение полностью с помощью ИИ?
Да, особенно для прототипов и небольших продуктов. Такой подход чаще называют вайбкодингом. Но чем сложнее приложение, тем важнее самостоятельно контролировать архитектуру, безопасность, тесты, миграции данных и зависимости.
Итог: какую нейросеть для кода выбрать
Если нужен один ИИ для программирования без привязки к IDE, я бы в первую очередь сравнил GPT-5.6 Sol, Claude Opus 5 и Gemini 3.1 Pro. Все три модели хорошо справляются с генерацией и анализом кода, а в нашем практическом тесте разрыв между ними оказался небольшим.
Для регулярной разработки большого проекта логичнее перейти от обычного чата к Codex, Cursor, Antigravity, Windsurf или Junie. Они видят больше контекста и могут самостоятельно выполнять часть инженерного workflow. Если же главная задача — найти бесплатный ИИ для кода, сначала стоит попробовать DeepSeek V4 Lite, GitHub Copilot Free и Google Antigravity.
Главный вывод теста оказался довольно простым: в 2026 году хорошие модели уже умеют находить большинство очевидных багов. Настоящая разница между ними проявляется позже — в том, насколько аккуратно ИИ исправляет проблему, не создает новую, правильно работает с конкурентностью и способен написать тест, который действительно доказывает исправление.
