


 Андрей Савченко
Качество данных: главный барьер для аналитики
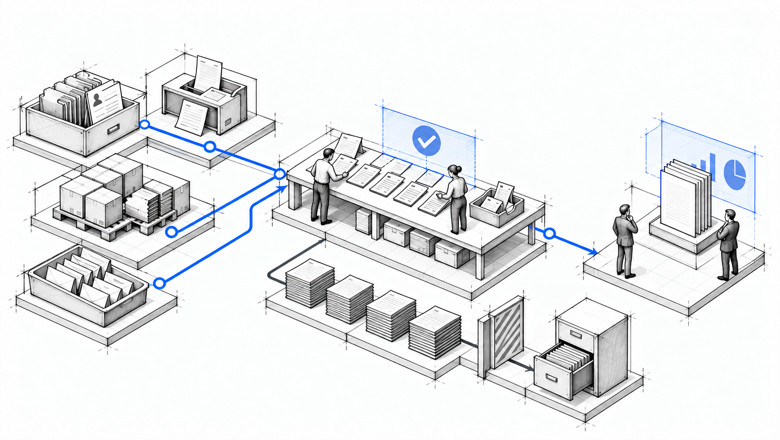
Эту часть работы специалисты выполняют вручную: разбирают документы, сравнивают отчёты отделов, задают вопросы сотрудникам и проверяют, какое бизнес-событие стоит за каждой цифрой.Работа над качеством данных для меня означает, что за показателем стоят подходящий источник, понятная формула и человек, который может подтвердить смысл расчёта. Когда эти правила согласованы, можно автоматизировать загрузку и пересчёт, сохранив возможность разобрать расхождение по исходным документам.
Что такое качество данных в управленческой аналитике?
Качество данных — это не только заполненные поля и успешная загрузка. Данные пригодны для управленческой аналитики, если для каждого показателя определены подходящий источник, понятная формула, период актуальности и ответственный со стороны бизнеса. Результат расчёта должен проверяться по исходным документам.В материале «Ведомостей» от 15 декабря 2025 года качество исходных данных названо одним из главных барьеров для «умной аналитики», и этот вопрос возникает ещё до выбора инструмента. Если AI строит отчёт по таблицам, у которых не проверили смысл полей и связи, он может выдать убедительный результат по данным, не подходящим для управленческого вопроса.
В RuDesktop пришлось договориться о том, что показывать руководству
В проекте для RuDesktop, разработчика ПО для удалённого управления устройствами, мы столкнулись с разными цифрами в отчётах маркетинга, прямых продаж и партнёрского отдела. Маркетинг вручную сводил сведения из Битрикс24, «Метрики», «Яндекс Директа» и 1С, причём форма отчёта менялась под очередной вопрос руководства.Мы собрали общие дашборды в DataLens, однако часть сотрудников продолжала пользоваться прежними отчётами, а единой формы документа для руководства всё ещё не было. Для регулярной отчётности закрепили согласованный способ считать выручку, а ответственным за подготовку документа для руководства стал маркетинг. 
Подготовка отчёта сократилась с нескольких дней до 5–6 рабочих часов. Эти часы включали разбор цифр и подготовку к планёрке, то есть после автоматизации сбора данных у сотрудников оставалась содержательная работа с результатом.
Для меня ценность этой работы в том, что у отделов появился общий способ считать выручку и понятная ответственность за отчёт. Готовый график не объяснит, почему два отдела по-разному учитывают одну сделку, пока эти правила не разобрали с людьми, которые её ведут.
Такой же разбор нужен справочникам клиентов, где один покупатель может оказаться в нескольких карточках CRM и получить отдельный код в 1С. Аналитик сверяет идентификаторы и историю операций, чтобы определить, какие записи относятся к одному заказчику, а какие действительно описывают разные компании.
Пустая себестоимость тоже требует разбирательства с источником, потому что при замене пропуска нулём расчёт может показать завышенную прибыль. До автоматизации этого показателя специалисту предстоит выяснить, где фиксируются затраты и по каким правилам их относят к конкретной продаже. 
Один заказ может превратиться в шесть строк без единого дубля в источнике
Покажу ещё одну ошибку на условном заказе стоимостью 120 000 рублей, в котором есть три товарные позиции и два платежа — на 40 000 и 80 000 рублей. В исходных таблицах всё записано правильно, но при подготовке отчёта товары и платежи соединяют между собой только по номеру заказа.
В результате каждой из трёх товарных строк соответствуют оба платежа, поэтому после объединения получается шесть строк, а сумма заказа повторяется в каждой из них. Если теперь посчитать строки и сложить денежные поля без учёта этих повторений, отчёт покажет следующие значения.
После такого объединения отдел продаж может выглядеть гораздо успешнее, хотя к реальным заказам не добавилось ни одного. Причина заложена в правилах соединения таблиц: для одного заказа мы получили все сочетания товарных строк и платежей, а затем ошибочно приняли их за самостоятельные операции.
При ручном разборе такого расчёта специалист выбирает один заказ и сверяет его сумму, товарные строки и оплаты с исходными документами. Для отчёта по заказам суммы платежей можно сначала собрать до одной строки на заказ, а товарные позиции использовать отдельно там, где нужен анализ состава покупки.
Если автоматически сгенерированный запрос проверили только на выполнение, такой отчёт сможет регулярно пересчитываться и каждый раз выдавать ту же завышенную сумму. Ручная сверка конкретного заказа с документами позволяет обнаружить ошибку в расчёте до того, как она станет частью регулярной отчётности.
Успешная выгрузка ещё не означает, что данные пригодны для анализа
Когда заказ не связан с клиентом, он может попасть в общий объём продаж и одновременно исчезнуть из анализа покупок конкретного заказчика. Платёж без привязки к договору тоже остаётся поступившими деньгами, но по нему нельзя надёжно определить, какую именно задолженность он погашает, пока назначение не установлено.
Такие записи стоит показывать отдельно, чтобы аналитик вместе с сотрудниками компании мог выяснить, где потерялась связь и как её восстановить. Если просто исключить их при подготовке данных, таблица станет аккуратнее, но часть операций выпадет из анализа вместе с вопросами, которые требовали разбирательства.
При интеграции ошибки возникают даже в тех данных, которые сотрудники изначально внесли правильно: повторная загрузка может добавить уже переданные документы, если обработка повторов не предусмотрена. А выгрузка только новых заказов оставит без внимания изменения старых, поэтому отменённый заказ способен продолжить участвовать в расчёте как действующий.
При разборе интеграций важно установить, на какой момент актуален каждый источник и можно ли сопоставлять эти данные в одном отчёте. Если этого не сделать, свежие заказы и устаревшие сведения о поступлениях могут создать видимость ухудшения оплат, хотя причина расхождения заключается в задержке загрузки.
В проекте для RuDesktop руководитель отдела внедрения вручную проверял события в календарях Битрикс24, чтобы посчитать презентации специалистов и затраченное на них время. Мы изучили документацию API, определили способ получить эти события и настроили загрузку с обновлением раз в час, чтобы руководитель работал с готовыми показателями в DataLens.
Поэтому рядом со статусом загрузки полезно контролировать количество документов, их суммы, время актуальности источника и долю записей с потерянными связями. Одной сверки общего итога недостаточно: платежи могут правильно складываться по компании и при этом распределяться по клиентам неверно, и такую ошибку сумма не обнаружит.
В TRI подходящий источник нашёлся в производственном учёте
В нашем проекте для TRI, производителя клеёв и других химических составов, расчёт закупок зависел от прогноза продаж, складских остатков и расхода компонентов. Рецептуры хранились в закрытых таблицах у разработчиков продуктов, а потребность в сырье каждый месяц собирала в Excel одна сотрудница, учитывая изменения от менеджеров.
Формат таблиц с рецептурами оказался неудобным для автоматического извлечения составов, а сами сведения заказчик считал конфиденциальными и не был готов переносить за пределы компании. Мы предложили посмотреть отчёт 1С о выпуске продукции и нашли там объём изготовленной партии вместе с количеством материалов, которые на неё потратили.
По этим записям мы рассчитали средний расход компонентов на 1 кг или 1 л продукта и связали его с прогнозом продаж и остатками. Между партиями встречались различия, поэтому подход согласовывали с заказчиком, а при настройке сравнивали варианты усреднения и статистику за 3 и 6 месяцев.
Специалист по закупкам могла открыть сведения о последнем выпуске, посмотреть использованные материалы и сопоставить полученные количества со своей оценкой. Для меня это пример ручной аналитической работы, которая определяет всю дальнейшую автоматизацию: выбор источника, допустимые расхождения и способ проверки результата.
Культура данных закрепляется в правилах и ответственности за цифры
После такого разбора у компании должно оставаться описание показателей, включённых в систему: что каждый из них означает, из какого источника берётся и как рассчитывается. В нём же фиксируются связи между объектами, период обновления и исключения, которые нельзя молча выбросить из отчёта ради аккуратного результата.
Для каждого такого правила нужен человек со стороны бизнеса, который подтверждает смысл расчёта и разбирает спорные случаи вместе с аналитиком. Когда меняются продукты, договорённости с партнёрами или учётные процессы, изменения должны доходить до загрузок и формул, чтобы отчёт продолжал описывать реальную работу компании.
Неоднозначные данные могут приводить к неточным или вводящим в заблуждение ответам. Пока источники и правила не проверены специалистами, такой ответ может ускорить принятие решения по ошибочным данным, особенно если его воспринимают как уже выполненную аналитическую работу.
Я считаю результатом проекта систему, в которой команда договорилась о смысле показателей, выбрала источники и умеет разбирать расхождения без пересборки отчёта с нуля. Повторяемые операции в такой системе выполняются автоматически, а ответственность за смысл цифр сохраняется у людей, которые знают процессы компании.
Как проверить качество данных перед автоматизацией?
- Определить управленческий вопрос и смысл каждого показателя.
- Зафиксировать источник, формулу, период обновления и ответственного.
- Сверить несколько заказов, оплат и затрат с исходными документами.
- Проверить ключи соединения таблиц, дубли и потерянные связи.
- Отдельно контролировать неполные, устаревшие и неоднозначные записи.
- Согласовать с бизнесом допустимые расхождения и порядок разбора исключений.
Прежде чем доверять системе управленческий вывод, я бы задал один вопрос: кто разобрал происхождение этой цифры, проверил её на документах и договорился с бизнесом, что именно она означает?
Пишу о BI, данных и управлении в телеграм-канале: https://t.me/smart3asy
Наш сайт https://smarteasybi.com
