
редакции

11 октября: как мы спасали SaaS-бизнес после атаки на дата-центры Яндекса и что из этого получилось
Всем привет!
Как вы думаете, что чувствует генеральный директор ИТ-компании, получая воскресным утром на телефон сообщение «Дата-центр „Яндекса“ во Владимире остановил работу после атаки БПЛА»?
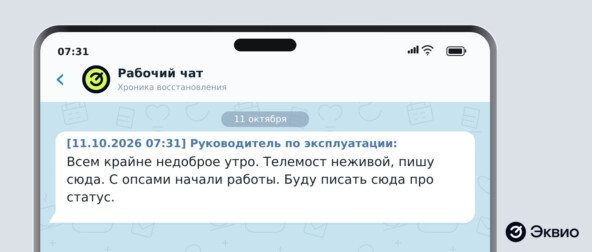
А в 7:31 — уже сообщение от сотрудника:
Представили? Ну, наверно, не очень живо.
А если добавить, что это уже третий дата-центр Яндекса, подвергшийся атаке за неделю, и что в этом дата-центре были данные некоторых наших клиентов, наши ИТ-продукты, программное обеспечение для разработки, которое кормило компанию и использовалось всеми сотрудниками ежедневно?
Еще трудно представить? Хорошо, представьте, что в один момент все ваши банковские счета, фоточки с телефона и документики с вашего компьютера пропали и вы остались наедине с запрещенным мессенджером, работающим через VPN, но без интернета?
Вот сейчас, наверно, появилась более яркая картинка. Но любителей драмы хочу немного разочаровать. Криков, звонков, экстренных совещаний с командой ранним воскресным утром, брейнштормов и прочих впечатляющих атрибутов кризис-менеджмента, увы, не было.
Пришло только в голову популярное выражение «Поздно пить боржоми, когда печень отвалилась».
В общем, я почувствовал себя абсолютно бесполезным в тот момент, потому что включились процессы, которые шли явно без моего участия и вовлечения, а наш воскресный чатик забурлил своей жизнью. Не скрою, волнующий холодок по спине ощутимо прошел, но тут уже надо было полагаться на «лодку судьбы» и команду, которая гребет в этой лодке. Всё, что мог сделать CEO в этой ситуации, он уже сделал — или было уже поздно. 
Ну а теперь немного ретроспективы и выводов по выживанию SaaS-сервиса для B2B на территории России в современных условиях.
Дам небольшую расшифровку непонятных слов и терминов для любознательного читателя. Я генеральный директор и основатель компании Эквио — e-queo.com.
Мы делаем ИТ-продукты для обучения и развития сотрудников в компаниях.
Чем больше сотрудников в компании, тем больше проблем с обучением и развитием персонала. Поэтому наша польза очевиднее там, где больше людей и где сложнее бизнес-процессы.
Как устроен бизнес таких компаний, как мы? Мы обычно продаем наш сервис с платформой «под ключ», в ИТ-мире это называется SaaS (Software as a Service). У клиента не болит голова о том, как это работает, потому что мы всё настраиваем, обновляем, чиним и всё время улучшаем. Клиент же сам создает контент, настраивает процессы обучения и смотрит аналитику результатов.
В нашем бизнесе очень важна ИТ-инфраструктура всего сервиса, чтобы всё бесперебойно работало и хранилось. Весь мир в последнее время шёл в сторону оптимизации и удешевления ИТ-инфраструктуры. Ведь проще и дешевле, чтобы всё это хранилось и работало в специальных дата-центрах. Это помогает выдерживать жесткие стандарты безопасности, соблюдать требования законодательства и страховаться от инцидентов (такие дата-центры оборудованы по высочайшим стандартам безопасности).
Мы были одними из самых первых клиентов Yandex Cloud. Яндекс Облако предоставляло нам всю ИТ-инфраструктуру и сопутствующий сервис под ключ, и это было особенно удобно компаниям вроде нашей, которые развивают свои продукты, но пока не имеют возможности вкладываться в серверы и систему безопасности. Наш бизнес рос, клиентам было суперудобно и надежно хранить свои данные в дата-центрах Яндекса. Дата-центры и сервис Яндекс Облака развивались и совершенствовались.
В силу специфики и возможностей нашей платформы по настройке и кастомизации (особенно мобильных приложений) мы особенно хорошо подходим крупным компаниям, где много пользователей, сложные процессы и заморочки с ИТ-безопасностью.
Мы брались за сложных клиентов с очень придирчивыми ИТ-безопасниками, которые буквально нас выворачивали наизнанку и всегда имели свое мнение о том, как должна выглядеть их ИТ-инфраструктура. Это привело нас к тому, что, кроме Яндекс Облака, мы научились работать и имели контракты со всеми крупными провайдерами дата-центров, причем некоторые крупные клиенты имели свои частные облака в этих центрах, и мы их там поддерживали. Но основным партнером и поставщиком для большинства наших клиентов все равно было Яндекс Облако.
Два слова про сохранность данных и доступность наших сервисов: бэкапы и восстановление работоспособности платформы в случае инцидентов — несколько разные вещи. За время нашей работы (а это с 2014 года) было многое. Что-то ломалось, выходило из строя, бывали и человеческие ошибки. Но я не помню случая, когда платформа полностью для всех клиентов не работала более часа.
Сохранность данных клиентов и ИТ-продуктов, пользующихся дата-центрами Яндекса, была устроена так.
Ежесуточно делались резервные копии со всеми данными клиентов и контентом, который насоздавали админы клиентов. Резервные копии хранились распределенно в нескольких дата-центрах Яндекса. Это позволяло даже в случае полного повреждения одного дата-центра из пяти основных вытащить наши данные, а мы всегда резервировали больше мощностей, чтобы было куда развернуть резервные копии наших клиентов и всё опять заработало.
Схема выглядела надежной и предсказуемой. Однако не для всех ИТ-безопасников. Несколько лет назад с приходом одного из таких клиентов возник фантастический тогда вопрос, больше похожий на риторический: «А что будете делать вы, если все дата-центры Яндекса полностью загнутся?»
Ну у нас же есть план Б! Есть действующие контракты с несколькими другими крупными дата-центрами, и мы можем переехать туда. Поэтому уже несколько лет мы дополнительно копируемся в другой дата-центр для особо требовательных клиентов на случай фантастической по тем временам ситуации, если Яндекс возьмет и испарится в мгновение.
Но в сентябре мы собрались с командой по новому поводу. Беспилотники начали летать по дата-центрам, и это было предвестником новых волнующих историй.
Крупные дата-центры особенно уязвимы, но удобство и дешевизна использования в текущих условиях менее приоритетны, чем сохранность данных и доступность сервиса. Пришло время децентрализации и готовности к быстрым переездам для всего бизнеса.
Для неайтишников приведу такой пример.
Вы живете в отеле, в прекрасном номере с удобствами. На всякий случай (если случится пожар или вас затопит сосед сверху) вы собрали тревожный чемоданчик со всем необходимым. Этот чемоданчик позволит вам комфортно расположиться в любом отеле. Отель вам гарантирует безопасность, и вы можете переехать в любой номер отеля. На всякий случай, когда вы уходите, вы сдаете свой тревожный чемоданчик на хранение охране на ресепшене. Что может случиться?
Вы вернулись, а ваш отель сгорел. Причем пришла новость, что это дело рук маньяка, который бегает по городу и сжигает крупные отели.
Мы заранее собрали свой дополнительный чемоданчик и отдали на хранение в неинтересное для маньяка место.
Но тут сразу возникает и другой вопрос. А куда переселиться? Есть ли другие отели, или там уже очередь из погорельцев? Поэтому всегда есть вопрос: а ждут ли вас в другом отеле, забронирован ли номер, примут ли вас с вашим тревожным чемоданчиком в новые апартаменты?
Поэтому вопрос правильных бэкапов и их хранения — это только часть вопросов в случае форс-мажорных ситуаций. Важно иметь четкий план, договоренности и подписанные резервы с другими дата-центрами.
Но самое важное — иметь профессиональную команду, которая действует согласно этому плану.
На этом с лирикой всё. Для любителей фактов ниже — небольшая хронология переписки, а в конце — мои выводы. По понятным причинам персональные данные коллег здесь не указываю.Итак,
[11.10.2026 07:31] Руководитель по эксплуатации: «Всем крайне недоброе утро. Телемост неживой, пишу сюда. С опсами начали работы. Буду писать сюда про статус».
[11.10.2026 07:43] — «Запросили квоты у cloud.ru, как договаривались. Они уже ответили. Фокусируемся на восстановлении инфры для разработки, потом начнем восстанавливать проды».
[11.10.2026 08:25] — Cloud.ru расширил квоты. Начинаем работы по поднятию продовых окружений. Как договаривались, начинаем с выделенных окружений. GitLab подняли. Jira и Confluence подняли.
[11.10.2026 09:26] — Помогите, плз, написать текст письма для облачных клиентов. Суть такая: в связи с аварией в Яндексе переносим ваше окружение в cloud.ru. Вам нужно внести изменения в DNS, вот такие...
[11.10.2026 09:28] — Бэкапы есть по всем проектам. Основную инфраструктуру восстановили почти всю, за исключением харбора (хранилище образов, большой объем, в процессе). Начали восстанавливать выделенные облака Эквио.
[11.10.2026 09:47] — Сайт Эквио https://e-queo.com/ подняли, работает. Леонид, проверьте, что функционал сайта (формочки, интеграции и т. п.) живой.
[11.10.2026 09:47] Коммерческий директор: публикуем официальные сообщения клиентам по всем каналам связи:
«Держим вас в курсе.
Восстанавливаем данные. Резервные копии есть — восстанавливаем из них.
Общее облако: действий не нужно. Возвращаем работу платформы централизованно.
Казахстан и зарубежные клиенты: сервисы работают в штатном режиме». 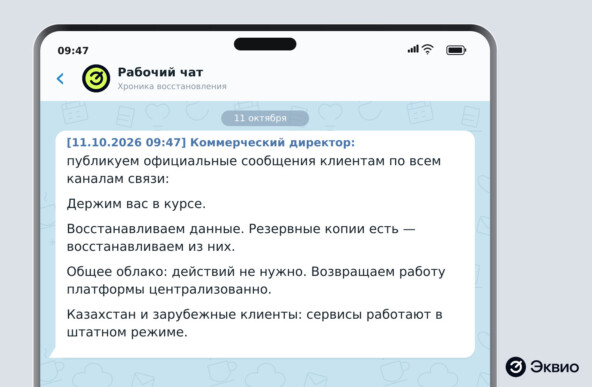
[11.10.2026 10:43] Коммерческий директор: нужно команды взбодрить и успокоить, мы все в частном порядке обсуждаем, ребята нервничают от непонимания. Я сейчас пришлю сообщение, можешь его отправить в наш общий внутренний чат Эквио от себя? И в ЯМ, и в ТГ.
[11.10.2026 10:53] Директор по ключевым клиентам: Валера, спасибо. Успокаиваем клиентов, разъясняем ситуацию. Не все в почту смотрят в выходные. По нашим клиентам всё в процессе, возможно, только [название клиента] завтра будет вносить DNS, если не найдут ИТ сегодня. Клиенты спрашивают временной коридор восстановления, чтобы перестроить свои процессы. На какой промежуток времени сориентировать?
[11.10.2026 10:53] Коммерческий директор: тут важно понимать, что это форс-мажор у нашего поставщика облачных ресурсов. Мы делаем всё возможное и занимаемся восстановлением данных и доступности сервиса.
[11.10.2026 10:58] Руководитель по эксплуатации — текущий статус:
1. Небольшие выделенные частные облака клиентов: восстановлены, про DNS клиентам написали. Некоторые клиенты просили не разворачиваться без «ок» от ИБ, запросили подтверждение, что новый провайдер cloud.ru соответствует 152-ФЗ. Дали черновик поручения на обработку ПДн.
2. Общее облако и большие выделенные окружения: в процессе восстановления, данные восстановлены, много контента, который восстанавливается постепенно.
3. Развитие талантов\HR аналитика: в процессе восстановления.
4. Авторизации, интеграции, специфичные настройки клиентов будем восстанавливать вместе с ними на следующей неделе. 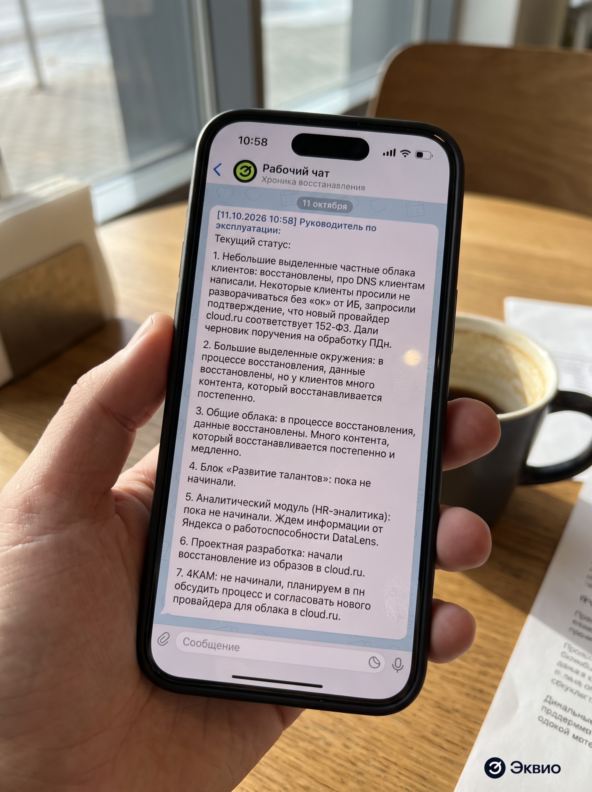
[11.10.2026 12:32] Alexey Vagin: «Яндекс» включил атаки БПЛА в перечень форс-мажорных обстоятельств https://www.rbc.ru/business/10/10/2026/6aca95716ff6d5fdafc490b8
[11.10.2026 12:36] Alexey Vagin: «Спасение утопающих — дело рук самих утопающих» (роман Ильи Ильфа и Евгения Петрова «Двенадцать стульев», 1928 год). 
В общем, дальше опять были лирика и детали: что у кого работает, а что надо починить позже. Поздно вечером в воскресенье наша команда из пяти DevOps-инженеров разошлась отдыхать с чувством выполненного долга и уже с несколькими полностью работающими клиентскими окружениями, остальные из-за огромного количества контента доезжали уже ночью автономно.
В сухом остатке итоги дня:
1. Было затронуто 12 продуктовых окружений (выделенных, общих и частных облаков) и 320 клиентов.
Плюс связанные сервисы: блок «Развитие талантов», HR-аналитика, 5 серверов проектной разработки, около 40 клиентских сайтов-лендингов.
2. За 6,5–7,5 часа мы восстановили техническую инфраструктуру клиентских окружений. Доступность для конечных пользователей возвращалась постепенно, по мере восстановления данных и переключения DNS. Последние выделенные окружения стали доступны 12 октября. Задержки на выделенных окружениях связаны с обновлением DNS-записей (ввиду смены провайдера дата-центра) на стороне клиентов. Какие-то настройки, интеграции, авторизации, требующие совместной работы с клиентами восстанавливались следующую неделю.
3. Контент у клиентов на небольших выделенных облаках доехал практически сразу, в момент восстановления. У самых крупных клиентов с большим количеством контента — за 34,5 ч от начала работ.
4. Точка восстановления была 10.10 в 00:00. Это целостный бэкап всех систем. Бэкап 11.10, к сожалению, не успел завершиться на всех окружениях из-за ночного инцидента.
5. Целостность восстановленных данных проверялась по хеш-суммам (контрольным суммам), все суммы сошлись.
Выводы и мысли о том, что будет дальше.
1) Нас спасло то, что резервирование данных было организовано вне основного облачного провайдера.
2) Были заранее подготовлены договорённости с альтернативными поставщиками инфраструктуры, был реальный опыт работы с ними, обсуждены все нюансы работы.
3) Команда заранее понимала порядок действий и распределение ответственности при аварийном восстановлении. Был согласован план аварийных работ.
Такая устойчивость стоит денег: резервные мощности у второго провайдера, хранение копий, трафик на переброску контента, работа команды в выходные. Раньше это был маловероятный сценарий и больше похож на страховку. Теперь это новый стандарт рынка, а уровень резервирования и гарантий от форс-мажора становится отдельным параметром сервиса. Это разная стоимость и это надо обсуждать с клиентами открыто.
Наше утро понедельника началось с сообщения, невольно вызвавшего улыбку у нашей техподдержки, вернувшейся к нормальному рабочему ритму.
[12.10.2026 10:06] Клиент: «Коллеги, здравствуйте. У меня пользователи не смогли войти в Академию в воскресенье утром. Что вообще происходит и когда это прекратится? Это недопустимо, у нас последние аттестации в понедельник».
И ведь клиент прав. Ему неважно, сколько дата-центров вышло из строя, сколько часов работали наши инженеры и как сложно было всё восстановить.
Приятно осознать, что мы нужны своим клиентам. Значит, наши ребята в воскресенье поработали не зря. В общем, извинились и сказали, что всё уже работает, аттестации проводить можно.
А наша команда спасла бизнес не потому, что в воскресенье совершила невозможное, а потому, что до воскресенья сделала всё необходимое.
P. S. Спасибо команде за прекрасные выходные.
Автор: Алексей Вагин — генеральный директор и основатель компании Эквио