



Алиса AI, ChatGPT, Perplexity, DeepSeek: как каждая нейросеть решает, что сказать о бренде
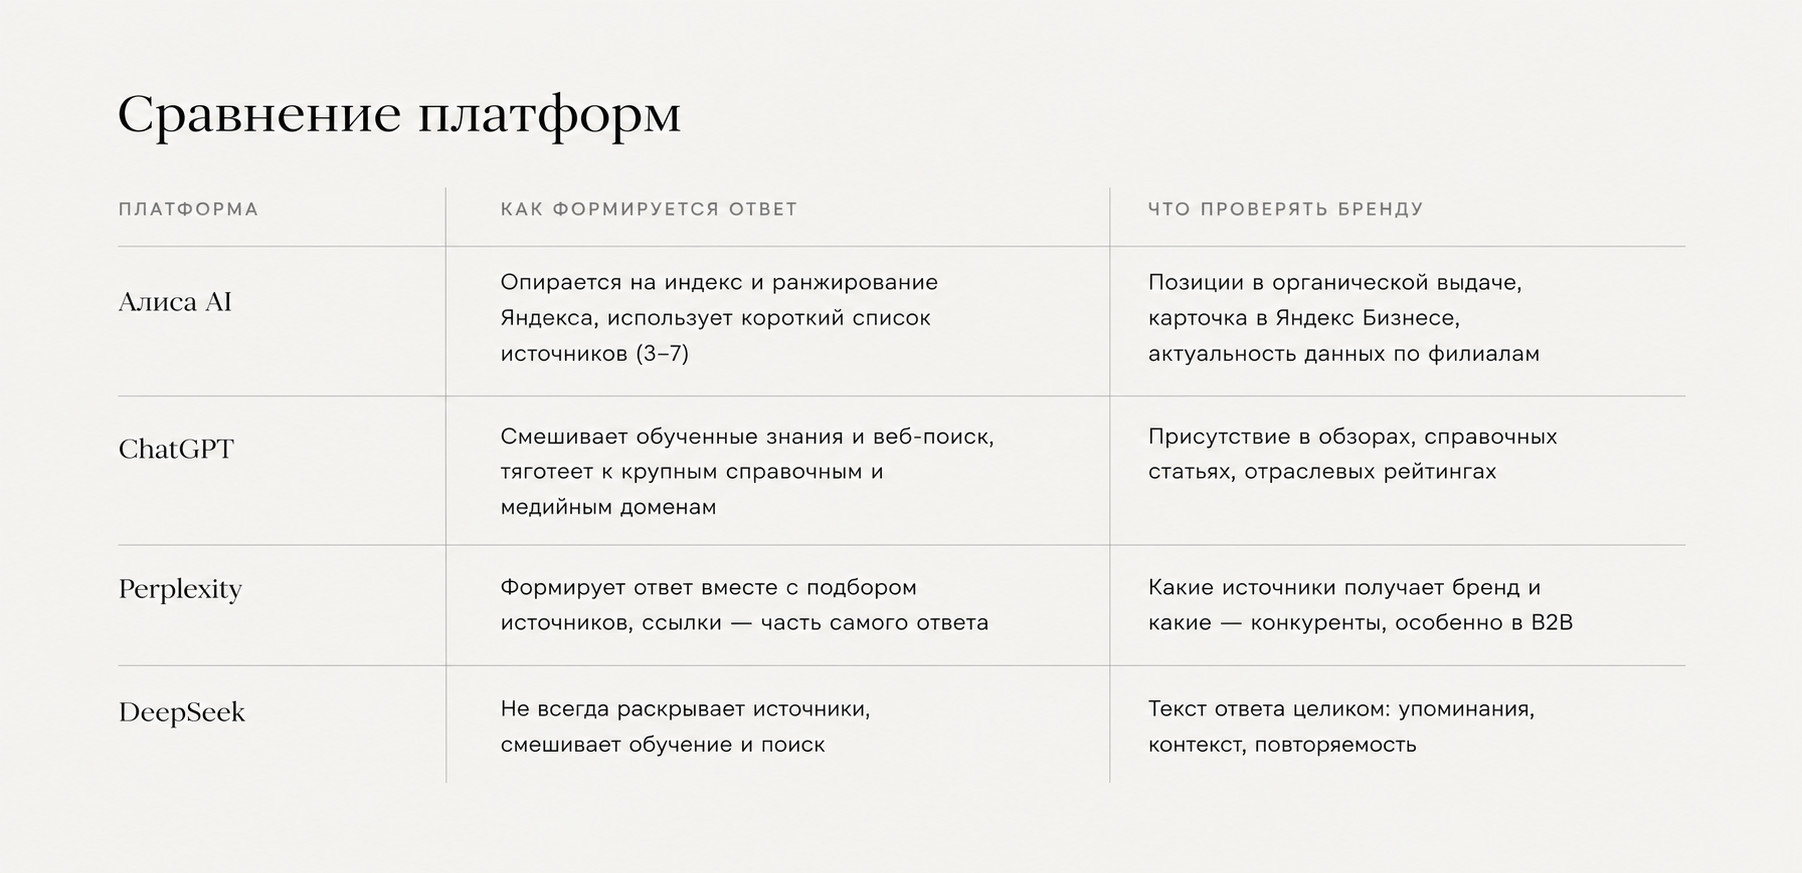
Алиса AI: ответ строится поверх поискового индекса Яндекса
Прежде чем что-то процитировать, нейропоиск Яндекса в первую очередь смотрит на сайты, которые уже хорошо ранжируются в обычной органической выдаче — это и есть основа механики. Поэтому рабочий контур у Алисы почти целиком локальный и русскоязычный: сайт, которого нет в топ-20 обычной выдачи, чаще всего вообще не рассматривается как кандидат на цитирование.
Российские GEO-агентства подтверждают это цифрами: сайт стал первым источником в 1 379 нейроответах, и среди запросов, где у сайта одновременно была и органическая позиция, и цитирование в ИИ-ответе, около 68% цитирований пришлось именно на те случаи, где сайт уже входил в топ-10 обычной выдачи. При этом ответ Алисы в среднем опирается всего на 3–7 источников — короткий список, в который сложно попасть без базовых SEO-позиций.
Поэтому карточка в Яндекс Бизнесе, актуальные данные о филиалах и адресах, отзывы и позиции в обычном поиске работают на AI-видимость напрямую, а не как отдельная параллельная задача.
ChatGPT: смесь обученных знаний и веб-поиска
ChatGPT формирует ответ из двух разных механизмов: части фактов, которые модель «помнит» после обучения, и результатов веб-поиска, если этот режим включён. Для многих фактологических запросов модель заметно чаще опирается на крупные справочные и медийные домены — это не оценка их качества, а статистическая закономерность в том, что модель «видела» на этапе обучения и чему в итоге доверяет при генерации ответа.
Несколько исследований 2026 года подтверждают это цифрами: Ahrefs, проанализировав свыше 9,6 млн запросов к ChatGPT, обнаружил, что по США лидером цитирования остаётся Reddit — около 16,7% всех ссылок среди топ-источников, следом идут Wikipedia, Amazon, Forbes и Business Insider. Исследование Profound уточняет: свыше 80% доменов, которые цитирует ChatGPT, — коммерческие сайты с доменом .com, а самый цитируемый отдельный источник — Wikipedia, около 7,8% всех цитирований.
Для бренда это значит, что попасть в такой ответ помогает не только собственный сайт, но присутствие в форматах, которые модель уже привыкла использовать — разборах, справочных статьях, отраслевых рейтингах.
Perplexity: источники подбираются вместе с самим ответом
Perplexity устроен как AI-поиск: модель формирует текст параллельно с подбором источников и показывает ссылки прямо в ответе, а не «за кадром». Из-за этого система тяготеет к материалам, которые легко использовать как прямое доказательство — исследованиям, документации, экспертным статьям, качественным обзорам.
По данным Evertune (около 200 млн промптов), Reddit — самый цитируемый домен в Perplexity, а на отдельных тематиках на него приходится до пятой части всех ссылок в ответе — самая высокая концентрация среди изученных платформ. Отдельное исследование Peec AI на выборке из 30 млн источников фиксирует ещё одну особенность именно Perplexity: здесь заметно чаще, чем на других платформах, встречаются профильные B2B-площадки вроде G2.
Именно поэтому набор источников, которым доверяет Perplexity, стоит отслеживать отдельно от ChatGPT — видимость в одной системе не переносится автоматически в другую.
DeepSeek: менее прозрачная атрибуция
DeepSeek не всегда показывает, на основании каких ссылок построен ответ, поэтому прямая атрибуция затруднена: не всегда понятно, откуда взялась рекомендация — из обучающих данных, из веб-поиска или из их комбинации. Из-за этого при мониторинге DeepSeek важнее фиксировать не ссылки, а сам текст ответа: упоминания бренда и конкурентов, контекст, фактические ошибки, повторяемость от замера к замеру.
Разница между платформами при этом бывает заметной: например, в индексе видимости банковского сектора AIMonitor.pro один и тот же лидер рынка получает совсем разную долю упоминаний в зависимости от платформы — в Алисе AI он заметно опережает остальных, а в DeepSeek второй игрок почти его догоняет. Один и тот же бренд может выглядеть безусловным фаворитом в одной модели и почти равным конкуренту — в другой.
Сравнение платформ
Почему наборы источников почти не пересекаются
Механика у платформ действительно разная. Peec AI (30 млн источников) показывает: Wikipedia уверенно цитируется в ChatGPT и Perplexity, но почти не встречается в Google AI Mode и AI Overviews — там на первый план выходят Facebook и Yelp. Обзор Similarweb по почти 600 000 случаям цитирования фиксирует похожую картину: Wikipedia и Reddit формируют львиную долю ссылок ChatGPT, а в Google AI Mode неожиданно лидирует Fandom.com. У каждой платформы — свой контур источников, и хорошая видимость в одной системе не гарантирует того же в другой.
Как использовать эту разницу на практике
- Проверяйте бренд не в одной нейросети, а сразу в нескольких — механика цитирования у них разная, и результат в одной не переносится на другую.
- Для Алисы — в первую очередь смотрите на позиции в обычной органической выдаче Яндекса и карточку в Яндекс Бизнесе: без этого попасть в короткий список из 3–7 источников почти нереально.
- Для ChatGPT и Perplexity — проверяйте, есть ли бренд в форматах, которые эти модели уже цитируют чаще прочих: разборах, отраслевых обзорах, структурированных страницах с фактами.
- Для DeepSeek — фиксируйте не ссылки, а сам текст ответа: упоминания, контекст, ошибки, повторяемость от замера к замеру.
- Сравнивайте платформы напрямую, а не по средней цифре «по больнице»: один и тот же бренд может быть лидером в одной модели и почти незаметным в другой.
- Повторяйте аудит регулярно — логика моделей и наборы источников меняются со временем.
AI-видимость сегодня определяется не одним «правильным» источником, а тем, совпадает ли то, что каждая конкретная модель знает о бренде, с тем, как именно она устроена — и как из имеющихся данных собирает ответ.